Schlagwort: Tools

  • Das Lab: warum Marketing seine eigenen Tools bauen sollte

    Das Lab: warum Marketing seine eigenen Tools bauen sollte

    Den größten Teil meines Berufslebens lief ein neues Tool im Marketing so ab: Lastenheft schreiben, auf einen Slot in der IT warten, auf Budget warten, sechs Monate später etwas bekommen, das fast macht, was du gebraucht hättest. Oder ein SaaS-Produkt kaufen, das 80 % davon kann und die restlichen 20 % unmöglich macht.

    Vor einem Monat haben wir etwas anderes probiert. Wir haben das gestartet, was wir das Lab nennen: ein internes Portal, in dem Marketing- und Vertriebsteams mit KI-Coding-Agenten ihre eigenen Tools bauen. Niemand von uns ist Entwickler. Ich kann ein bisschen HTML und CSS, meine Kolleginnen und Kollegen ungefähr gleich viel.

    Nach vier Wochen gibt es im Lab einen täglichen Chat-Qualitätsreport, einen Finder für Dokumentationslücken, eine Seite mit Marktkennzahlen, eine Beobachtungsliste für Kundentickets, bei denen es still geworden ist, einen Social-Media-Analyser und ein Coaching-Tool für unsere Seminarlocation. Für die meisten davon hat es ein oder zwei Tage bis zur ersten brauchbaren Version gedauert.

    In diesem Beitrag geht es darum, wie das funktioniert, und warum die wichtigste Zutat nicht das KI-Modell ist.

    Der Agent ist der einfache Teil

    Moderne Coding-Agenten schreiben sehr guten Code. Das ist nicht mehr der Engpass. Der Engpass ist, dass der Agent nichts über dein Geschäft weiß. Er weiß nicht, was ein „qualifizierter Lead“ in deinem Unternehmen bedeutet, in welchem CRM-Feld die Partnerstufe steht, warum die Instagram-Zahlen vom letzten Quartal seltsam aussehen oder dass dein Support-Team Tickets auf eine bestimmte Art schließt.

    Gib einem Agenten eine vage Aufgabe und keinen Kontext, und du bekommst ein generisches Dashboard, das toll aussieht und die falsche Frage beantwortet. Gib ihm den richtigen Kontext, und er baut etwas, das sich anfühlt, als hätte es jemand gemacht, der seit Jahren mit dir zusammenarbeitet.

    Die eigentliche Arbeit im Lab ist also nicht das Prompten. Es ist der Aufbau von Kontext.

    Drei Arten von Kontext

    1. Was wir wissen: einfache Markdown-Dateien. Alles, was die Agenten verstehen müssen, liegt als Textdatei vor. Mein eigenes Wissen halte ich in einem Obsidian-Vault fest: wer wir sind, wie wir über unsere Produkte sprechen, Markenrichtlinien, die für KI-Agenten statt für Designer geschrieben sind, Definitionen unserer Kennzahlen. Zusammenfassungen von Meetings landen jeden Abend automatisch im Vault.

    Jedes Projekt-Repository hat eine Einstiegsdatei, AGENTS.md, die jeder Agent zuerst liest, egal ob Claude Code, Codex oder etwas anderes. Daneben liegt ein docs/-Ordner mit Entscheidungen und Erkenntnissen, jeweils mit Datum und Begründung. Wenn ein Agent oder ein Mensch etwas Nicht-Offensichtliches lernt, wird es dort aufgeschrieben. Nicht in einem Chat. Nicht im Gedächtnis eines einzelnen Tools. Im Repo, wo der nächste Agent es findet.

    Eine Regel hat sich als sehr wichtig herausgestellt: Jede Definition steht an genau einem Ort. Als ich im August meinen Vault aufgeräumt habe, waren unsere Markenfarben an sechs Stellen definiert und ein Prozess an neun Stellen beschrieben. Agenten nehmen fröhlich die Version, die sie zuerst finden.

    2. Was gerade passiert: Live-Verbindungen zu unseren Systemen. Kontext heißt auch Daten. Über MCP-Server (die „USB-Anschlüsse“, über die KI-Agenten mit anderer Software sprechen) und APIs können die Agenten unser CRM, unseren Helpdesk, unseren Live-Chat, unsere Social-Media-Analytics und unsere Produktdatenbank lesen. Ein Tool, das „aktive Partner pro Markt“ anzeigt, verwendet keinen Export vom letzten Monat. Es fragt das CRM ab, wenn es läuft.

    So ist auch eine unserer nützlichsten Seiten entstanden. Dieselbe Kennzahl war in Präsentationen mit drei verschiedenen Definitionen unterwegs. Jetzt gibt es eine Definition, einmal aufgeschrieben, und das Tool berechnet sie live. Die Diskussion hat sich von „Wessen Zahl stimmt?“ zu „Was machen wir jetzt damit?“ verschoben.

    3. Was schiefgegangen ist: Erkenntnisse direkt in den Tools. Jeder Skill und jedes Tool hat seine eigene Liste an Fallen. Zum Beispiel: „Lass nie einen KI-Sub-Agenten Tickets aus dem Helpdesk holen, dabei gehen die Filter verloren und du bekommst eine Million Ergebnisse statt ein paar Hundert.“ Diese Notizen sehen langweilig aus. Sie sind der Grund, warum der zweite Durchlauf eines Tools besser ist als der erste.

    Was wir tatsächlich gebaut haben

    Ein paar Beispiele, damit es konkret wird:

    • Chat-Reports. Jeder Live-Chat vom Vortag wird von einer KI gelesen und bewertet: Wurde er angenommen, wie lange hat der Kunde gewartet, wurde eine Verkaufschance verpasst, wurde der Kunde zu früh weggeschickt. Das vollständige Protokoll steht neben der Bewertung, damit jeder nachprüfen kann.
    • Dokumentationslücken. Abgeschlossene Support-Tickets werden mit unserer öffentlichen Wissensdatenbank abgeglichen. Was der Support schriftlich erklären musste, fehlt wahrscheinlich in der Dokumentation. Das Tool schlägt den Text vor, der ergänzt werden sollte.
    • Social-Analyser. KPIs über unsere Marken-Accounts hinweg, das Sentiment jedes Kommentars und jeder DM, eine Liste der Leute, die noch auf eine Antwort warten, und Content-Ideen, die auf die echten Posts und Kommentare verlinken, aus denen sie stammen. Den Großteil davon hat eine Marketing-Kollegin gebaut, nicht ich.
    • Ticket-Beobachtung. Offene Tickets, bei denen ein Kunde wartet und seit Tagen niemand geantwortet hat.
    • Location-Coaching. Anfragen für unsere Seminarlocation, aus denen keine Buchung wurde, warum nicht, und was sie wert gewesen wären.

    Nichts davon ist ausgefeilte Software. Die Tools sind klein, konkret und von den Leuten gebaut, die sie auch nutzen. Genau darum geht es.
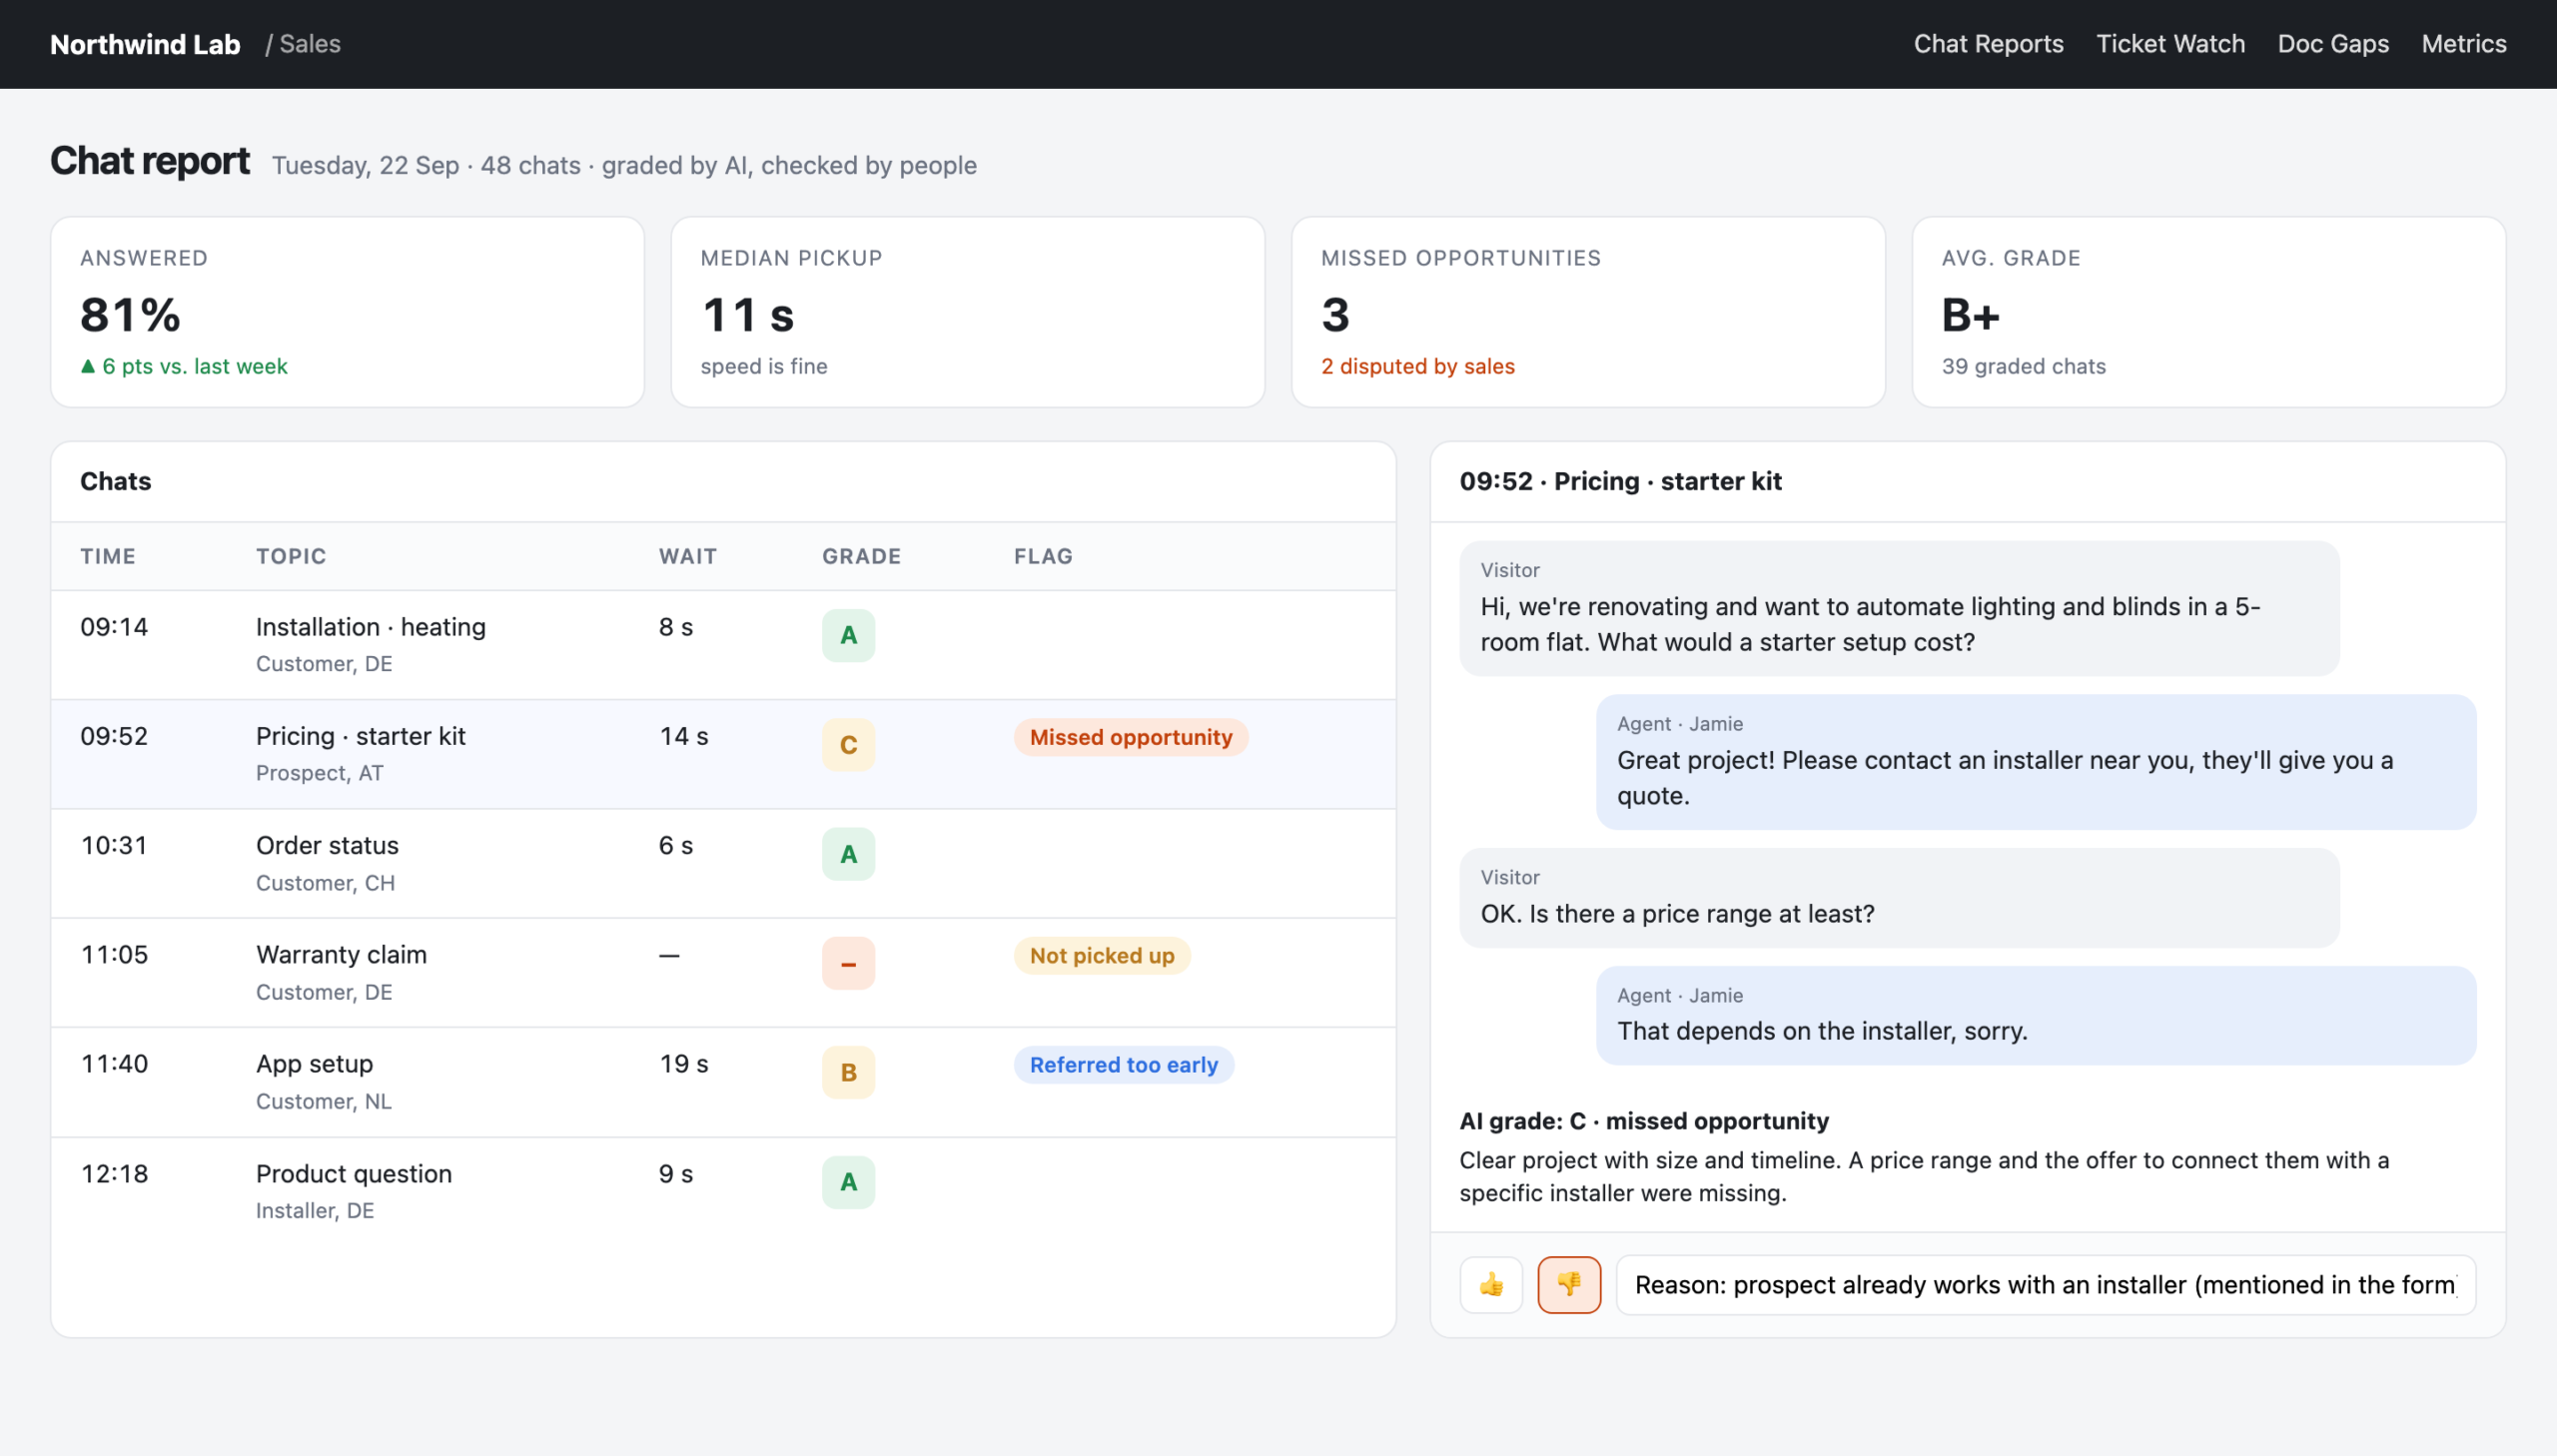
    Chat-Report: von der KI bewertete Chats, das Transkript direkt neben der Note
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Wie Teams unabhängig bleiben (von der IT und voneinander)

    Jedes Team bekommt im Portal seinen eigenen Bereich: seine eigene kleine App, seinen eigenen Pfad, seinen eigenen Deploy. Wenn Marketing etwas kaputtmacht, geht der Bereich von Marketing kaputt, nicht das ganze Portal. Wer neu dazukommt, bekommt eine Einladung und einen „Prompt kopieren“-Button. Der Prompt weist den eigenen KI-Agenten an, das Projekt zu klonen, AGENTS.md zu lesen und die Onboarding-Checkliste abzuarbeiten. Das Wissen bleibt im Repo, der Prompt zeigt nur dorthin.

    Alles läuft auf Cloudflare mit einem Login davor. Nichts ist öffentlich, und niemand musste ein Login-System bauen. Wer etwas ansehen will, braucht nur eine Firmen-E-Mail-Adresse.

    Wir haben uns die Alternativen angeschaut. Ein BI-Tool mit Preis pro Nutzer und ohne Möglichkeit, Daten einzugeben. Ein Plattformprodukt für mandantenfähige Apps, das für drei Teams mehr gekostet hätte, als es wert war. Getrennte Repositories pro Team. Am Ende haben wir die einfachste Variante gewählt, die funktioniert: ein Repository, mehrere Bereiche, Absprache statt Zwang.

    Ist das eine Bedrohung für die IT?

    Nein. Die IT betreibt weiterhin die zentralen Systeme, kümmert sich um Sicherheit und um alles, was grundsolide sein muss. Was sich ändert, ist der Long Tail: die Hunderten kleinen Reports, Prüfungen und Helfer, die nie wichtig genug für ein IT-Projekt waren, aber die Woche eines Marketingteams spürbar verändern.

    Dafür lautete die Antwort bisher „Lebt ohne“ oder „Baut es in Excel“. Die neue Antwort ist: Bau es selbst, und gib deinem Agenten den Kontext, den er braucht.

    Wo du anfangen kannst

    Wenn du das in deinem Team ausprobieren willst:

    1. Schreib auf, was du weißt. Fang mit einer Markdown-Datei an: wer ihr seid, was eure Kennzahlen bedeuten, wie eure Tonalität ist. Halte jede Definition an einem einzigen Ort.
    2. Verbinde ein System. Nimm das, auf das du am häufigsten schaust (CRM, Helpdesk, Social-Media-Analytics), und verbinde es über einen MCP-Server oder eine API.
    3. Bau ein kleines Tool für eine echte Frage. Kein Dashboard. Eine Frage, etwa „Welche Kunden warten gerade auf eine Antwort?“
    4. Schreib auf, was schiefgegangen ist, mit Datum. Diese Datei wird dein wertvollstes Asset.

    Die Tools sind der sichtbare Teil. Was du wirklich aufbaust, ist der Kontext.
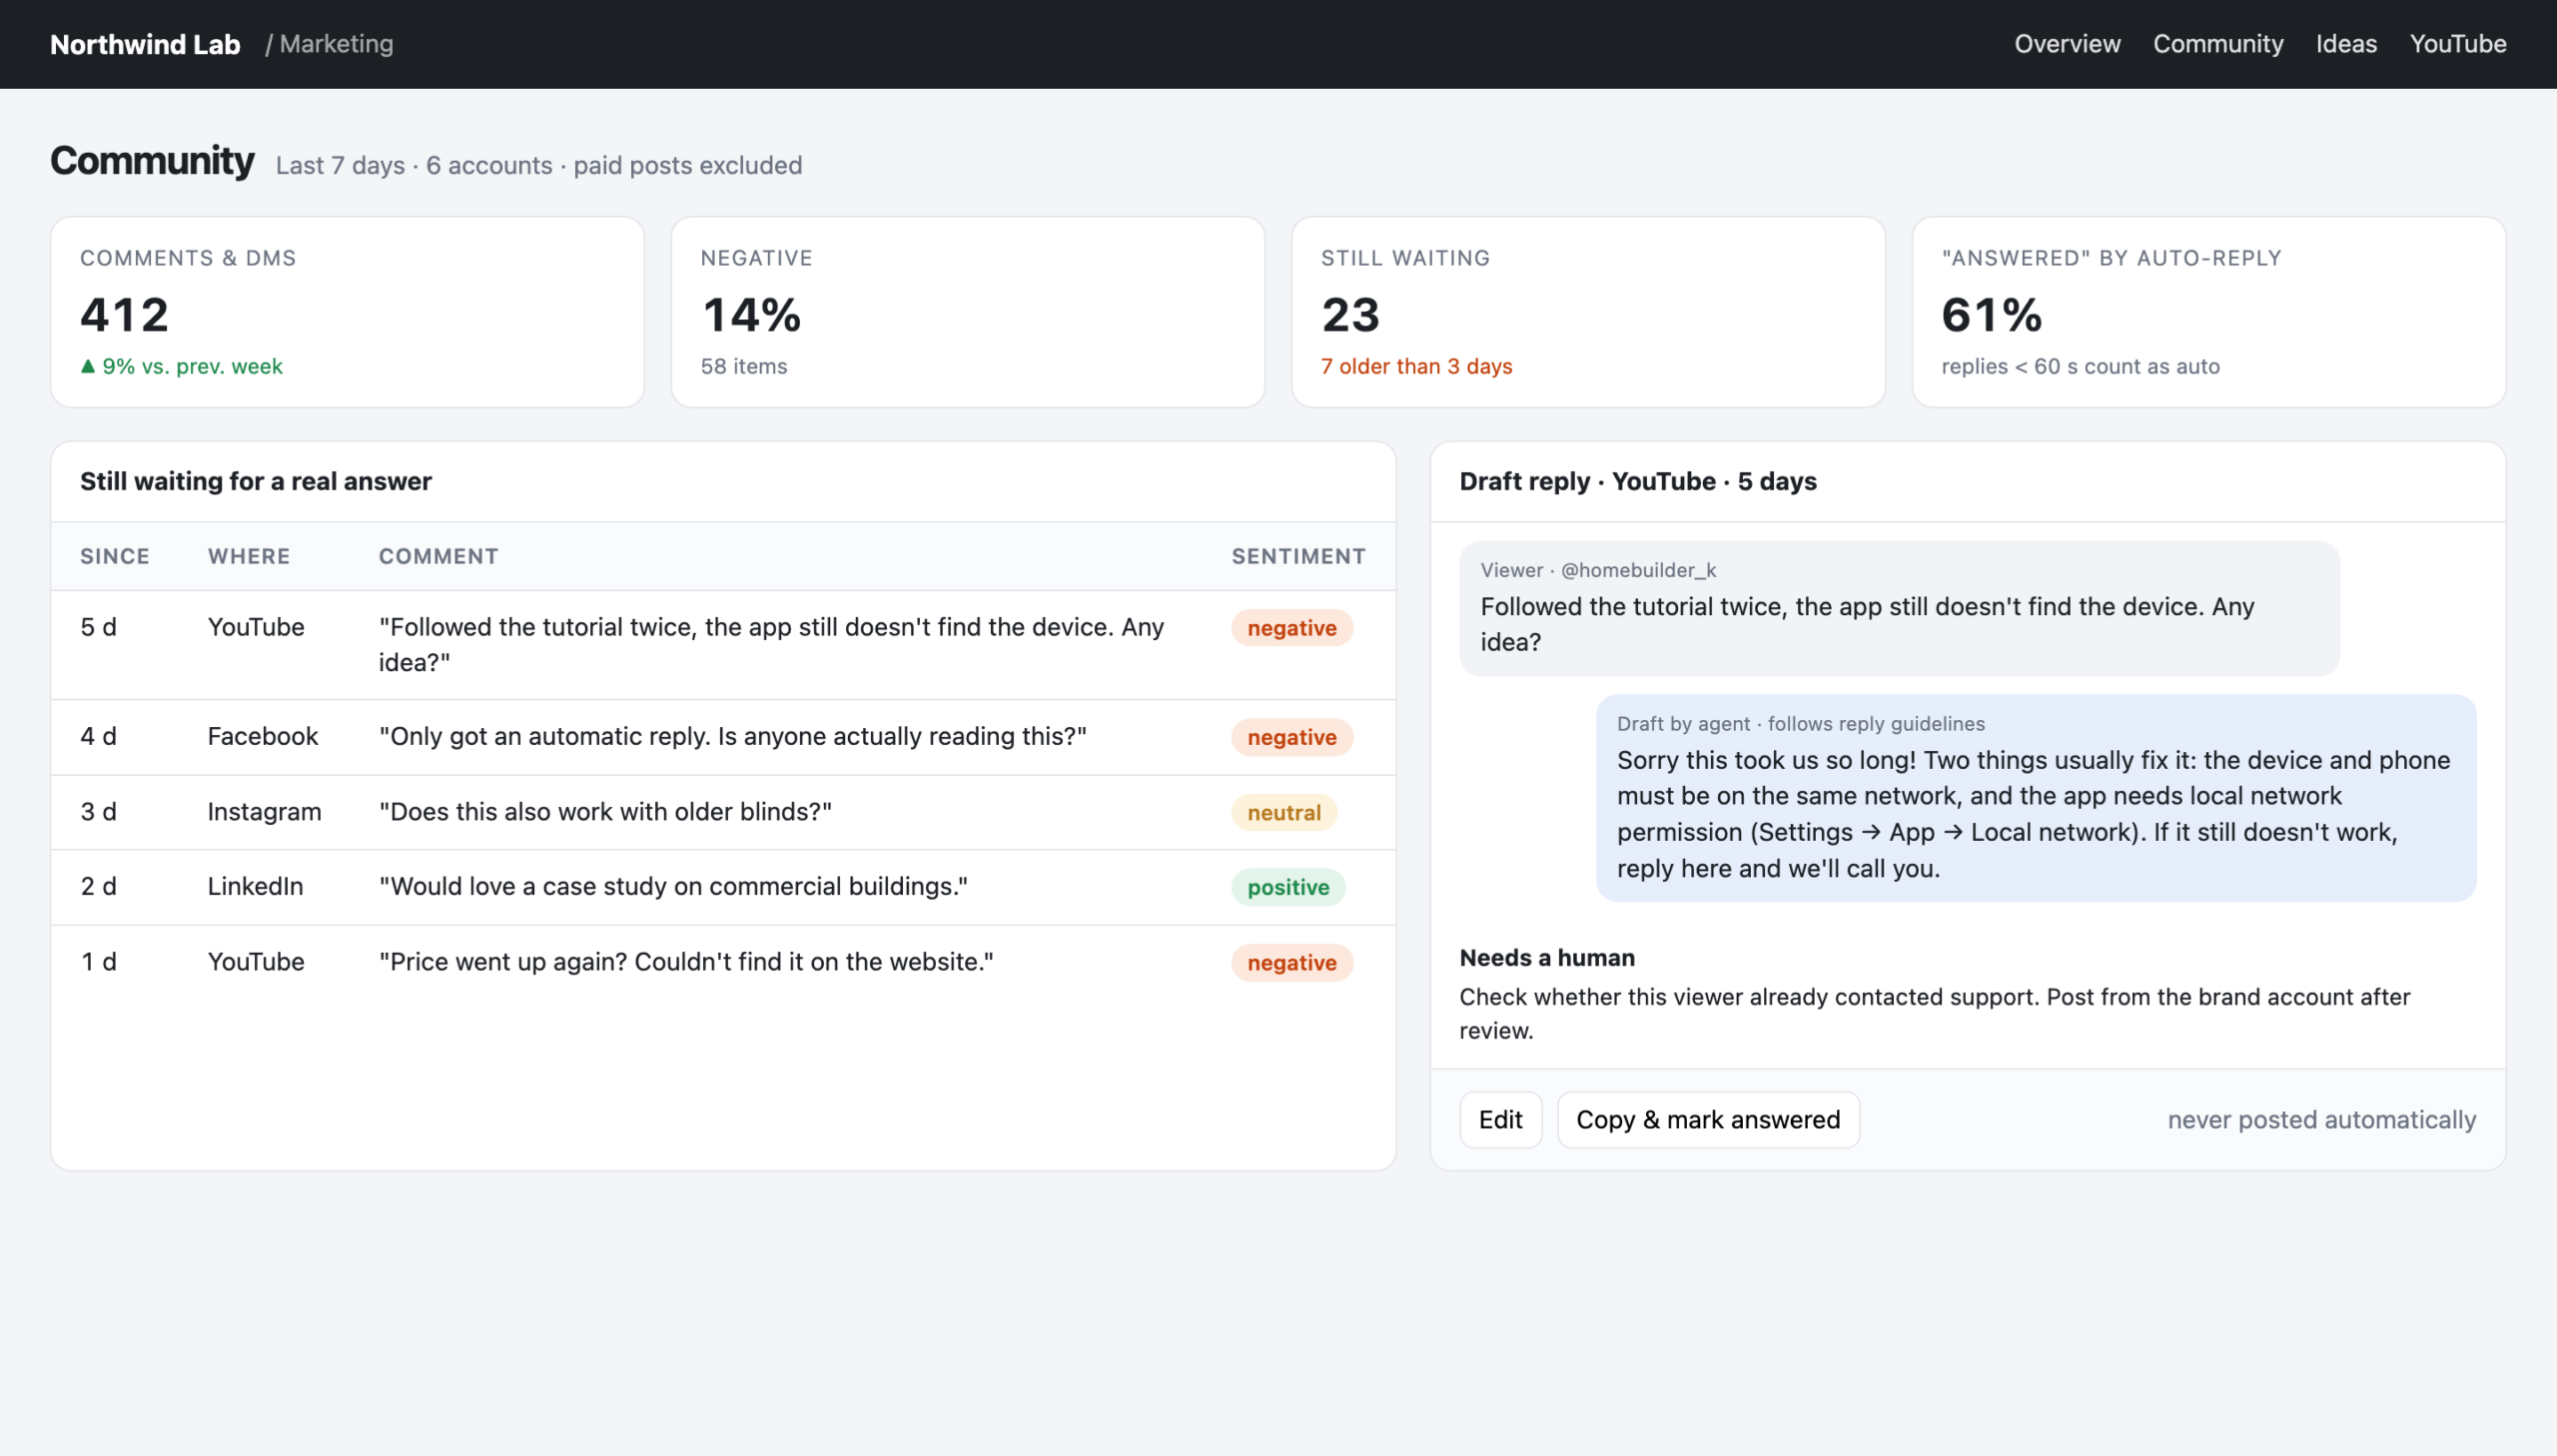
    Community-Ansicht: wer noch auf eine echte Antwort wartet, mit Antwortentwurf
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.
  • Ich kann nicht programmieren. Trotzdem läuft bei mir alles auf Cloudflare.

    Ich kann nicht programmieren. Trotzdem läuft bei mir alles auf Cloudflare.

    Zuerst ein Geständnis: Ich bin kein Entwickler. Ich kann einfaches HTML schreiben, mit CSS eine Seite ganz ordentlich aussehen lassen, und ich weiß ungefähr, was eine Datenbank ist. Das war’s.

    Trotzdem betreibe ich seit dieser Woche sechs Websites und kleine Apps auf meinen eigenen Domains. Da ist ein privates Finanz-Dashboard mit Datenbank hinter einem Login. Da ist ein Tool, das die Ladevorgänge der Wallbox einer Familie sammelt und daraus monatliche Belege erstellt. Dazu zwei Websites für Vereine aus der Gegend, eine persönliche Landingpage und der Blog, den du gerade liest. Alles läuft auf einem einzigen Cloudflare-Konto.

    Den Code habe nicht ich geschrieben. Das haben KI-Coding-Agenten gemacht, vor allem Claude Code und Codex. Meine Aufgabe war, zu entscheiden, was ich will, zu prüfen, was zurückkommt, und ein Hosting-Setup zu wählen, das jemand wie ich tatsächlich versteht und am Laufen halten kann. Um diesen letzten Punkt geht es hier, weil er wichtiger ist, als viele glauben.

    Das eigentliche Problem ist nicht das Programmieren

    Wer als Marketer mit KI-Agenten experimentiert, merkt schnell: Code schreiben zu lassen ist nicht mehr das Schwierige. Du beschreibst, was du willst, und ein paar Minuten später läuft etwas auf deinem Laptop.

    Schwierig wird es danach. Wo läuft das Ganze? Wer spielt die Updates am Server ein? Was passiert, wenn um 23 Uhr etwas kaputtgeht? Wie verhindere ich, dass das ganze Internet meine Finanzdaten sieht? Klassisches Webhosting beantwortet diese Fragen mit Dingen, die ich nicht kann: per SSH auf Server zugreifen, Nginx konfigurieren, Zertifikate erneuern, PHP aktualisieren, Datenbank-Backups verwalten.

    Ich brauchte ein Setup, bei dem der Agent die Arbeit macht und ich trotzdem noch verstehe, was passiert.

    Was ich tatsächlich verwende

    Alles folgt demselben einfachen Muster:

    • Workers mit statischen Assets. Jede Website ist ein Ordner mit einfachem HTML, CSS und ein bisschen JavaScript, dazu ein kleines Skript (ein „Worker“), das im Netzwerk von Cloudflare läuft. Kein Server, um den ich mich kümmern muss.
    • D1 für die Datenbanken. Unter der Haube steckt SQLite. Die Daten sind also eine einzige Datei, die ich herunterladen und selbst öffnen könnte, wenn ich wollte.
    • R2 für Dateien, etwa die Foto-Uploads auf einer Vereinsseite oder die Bilder auf diesem Blog.
    • Cloudflare Access, um alles Private hinter einen Login zu stellen. Meine Finanz-App ist nur erreichbar, nachdem ein Code an meine eigene E-Mail-Adresse gegangen ist. Ein eigenes Login-System musste ich dafür nicht bauen.
    • DNS am selben Ort. Die Domains liegen ohnehin bei Cloudflare. Eine neue Subdomain mit einem Worker zu verbinden, ist eine Zeile in einer Konfigurationsdatei.

    Und das Wichtigste: Alles ist in Dateien im Projekt beschrieben. Pro Projekt gibt es eine Konfigurationsdatei, in der steht, welche Datenbank, welcher Speicher-Bucket und welche Domain verwendet werden. Ein Deploy ist ein einziger Befehl. Kein Herumklicken in Dashboards, an das sich eine Woche später niemand mehr erinnert.

    Warum das so gut zu Nicht-Entwicklern passt

    Ein Ort, eine Rechnung, großteils gratis. Meine Websites haben keine Millionen Besucher. Das kostenlose Kontingent deckt fast alles ab, und falls ich es je überschreite, startet der bezahlte Workers-Plan bei fünf Dollar im Monat. Ich habe nicht fünf Hosting-Anbieter mit fünf Logins und fünf Rechnungen.

    Nichts zu patchen. Unter meinen Websites liegt kein Betriebssystem, für das ich verantwortlich bin. Allein das beseitigt die unangenehmste Art von Problemen für jemanden wie mich.

    Agenten verstehen es. Das hat mich überrascht. Weil das ganze Setup aus Dateien besteht (eine Konfiguration, ein Datenbankschema, ein Ordner mit Seiten), kann ein KI-Agent es lesen, ändern und deployen. Wenn ich sage: „Füge eine Seite hinzu, die die Ladevorgänge vom letzten Monat zeigt“, weiß der Agent, wo die Datenbank ist, wie sie aufgebaut ist und wie er die Änderung live bringt. Ein Hosting-Setup, das in einem Web-Dashboard lebt, ist für den Agenten unsichtbar. Ein Setup in Dateien ist etwas, womit er arbeiten kann.

    Zurückrollen ist eingebaut. Jeder Deploy ist eine Version. Wenn etwas kaputtgeht, ist der Weg zurück ein einziger Befehl. Bei zwei Vereinswebsites habe ich das alte Hosting sogar parallel weiterlaufen lassen: Der Worker sitzt einfach davor. Entferne ich eine Route, ist die alte Seite wieder live. Genau so ein Sicherheitsnetz willst du, wenn du nicht ganz sicher bist, ob du weißt, was du tust.

    Sicherheit, die ich nicht selbst bauen musste. Access vor eine App zu stellen, war ein einziger Einrichtungsschritt. Einen sicheren Login selbst zu bauen (oder besser gesagt: darauf zu vertrauen, dass ein Agent ihn richtig baut) wäre ein viel größeres Risiko gewesen.

    Was schiefgegangen ist (damit du es nicht wiederholen musst)

    Zauberei ist es nicht. Ein paar Dinge haben mich erwischt, und alle stehen jetzt in den Projekten, damit weder ich noch der nächste Agent wieder darauf hereinfallen:

    • Zwei Konten, ein Fehler. Ich habe ein berufliches und ein privates Cloudflare-Konto auf demselben Laptop. Ein Agent hat einmal eine Datenbank im falschen Konto angelegt, weil das Tool, das er verwendet hat, mit dem beruflichen Konto verbunden war. Jetzt steht in jedem privaten Projekt die ID des privaten Kontos in der Konfiguration. Ein Deploy ins falsche Konto schlägt damit einfach fehl.
    • „Auto-Deploy“ hat nicht deployed. Eine Website sollte sich bei jedem Push auf GitHub neu deployen. Irgendwann hat sie damit einfach aufgehört, ohne jede Meldung. Die Lösung war nicht technisch, sondern eine Gewohnheit: Nach einer Änderung prüfen, welche Version live ist.
    • Ein Login, der keiner war. Bei einer App hat Cloudflare die HTML-Dateien direkt ausgeliefert, noch bevor meine Login-Prüfung überhaupt lief. Die Daten dahinter waren geschützt, die Seite selbst nicht. Eine einzige Einstellung („Worker zuerst ausführen“) hat es behoben. So etwas findest du nur, wenn du wie ein Außenstehender testest.
    • Fehlermeldungen lügen manchmal. Einmal behauptete das Deploy-Tool, ich sei nicht eingeloggt. Ich war es. Ein Plugin hatte einen Ordner angelegt, der es durcheinandergebracht hat. Ein Agent hat das in Minuten gefunden. Ich hätte Tage gebraucht.

    Worum es eigentlich geht

    Jahrzehntelang hieß „Ich bin nicht technisch“ so viel wie „Dafür brauche ich jemanden aus der IT oder eine Agentur“. Mit KI-Agenten ändert sich das, aber nur, wenn die Plattform darunter einfach genug ist, dass du den Überblick behältst. Für mich ist diese Plattform Cloudflare. Für dich ist es vielleicht eine andere.

    Meine Faustregel: Wähle eine Plattform, auf der sich dein ganzes Setup in einfachen Dateien aufschreiben lässt. Dann können sowohl du als auch deine Agenten es lesen. Genau das macht aus „Der Agent hat mir ein bisschen Code geschrieben“ ein „Ich betreibe das selbst“.

    Dieser Blog ist übrigens mein neuestes Experiment. Er läuft auf EmDash, einem neuen Open-Source-CMS, das auf Cloudflare läuft, und ich teste es als Alternative zu WordPress. Mehr dazu, wenn ich eine Weile damit gelebt habe.