Schlagwort: Analytics

  • Miss die Antwort, nicht die Frage

    Miss die Antwort, nicht die Frage

    Jedes Unternehmen sitzt auf einem riesigen Stapel ungelesener Marktforschung. Er heißt Support-Postfach. Jeder Live-Chat, jedes Ticket, jede E-Mail ist ein Kunde, der dir in eigenen Worten sagt, was er nicht versteht, was er will und wo dein Produkt oder dein Content ihn im Stich lässt.

    Marketing liest das selten. Nicht, weil es niemanden interessiert, sondern weil niemand Zeit hat, Tausende Gespräche zu lesen. Mit KI gilt diese Ausrede nicht mehr. Ein Agent kann jedes Gespräch von gestern lesen, bevor du deinen ersten Kaffee getrunken hast.

    Wir machen das jetzt seit ein paar Wochen. Das haben wir dabei gelernt.

    Der Trick: Schau, was der Support erklären musste

    Unsere erste Idee war naheliegend: die Kundenfragen nehmen, prüfen, ob unsere Wissensdatenbank sie beantwortet, und die Lücken auflisten. Das hat nicht gut funktioniert. Kunden stellen vage Fragen in ihren eigenen Worten. „Es geht nicht mehr“ passt zu keinem Artikel.

    Der Durchbruch kam, als wir es umgedreht haben. Miss nicht die Frage. Miss die Antwort. Schau dir an, was die Person im Support schreiben musste, um den Fall zu lösen. Wenn der Support etwas ausführlich und schriftlich erklären musste, ist genau diese Erklärung das, was in der Dokumentation fehlt.

    Mit dieser Änderung wurde die Lückenanalyse über Nacht brauchbar. Für jedes abgeschlossene Ticket vergleicht das Tool die Antwort aus dem Support mit unserer Wissensdatenbank. Es verwendet eine einfache Stichwortsuche über eine lokale Kopie aller Artikel, das ist schnell und braucht überhaupt keine KI. Wo es eine echte Lücke gibt, entwirft es den Text, der ergänzt werden sollte. Das Dokumentationsteam markiert jeden Fund als offen, übernommen oder verworfen.

    Eine Regel hält das Ganze ehrlich: Ein Thema gilt nur dann als „nicht dokumentiert“, wenn die Suche mit mindestens zwei unterschiedlichen Formulierungen nichts gefunden hat.
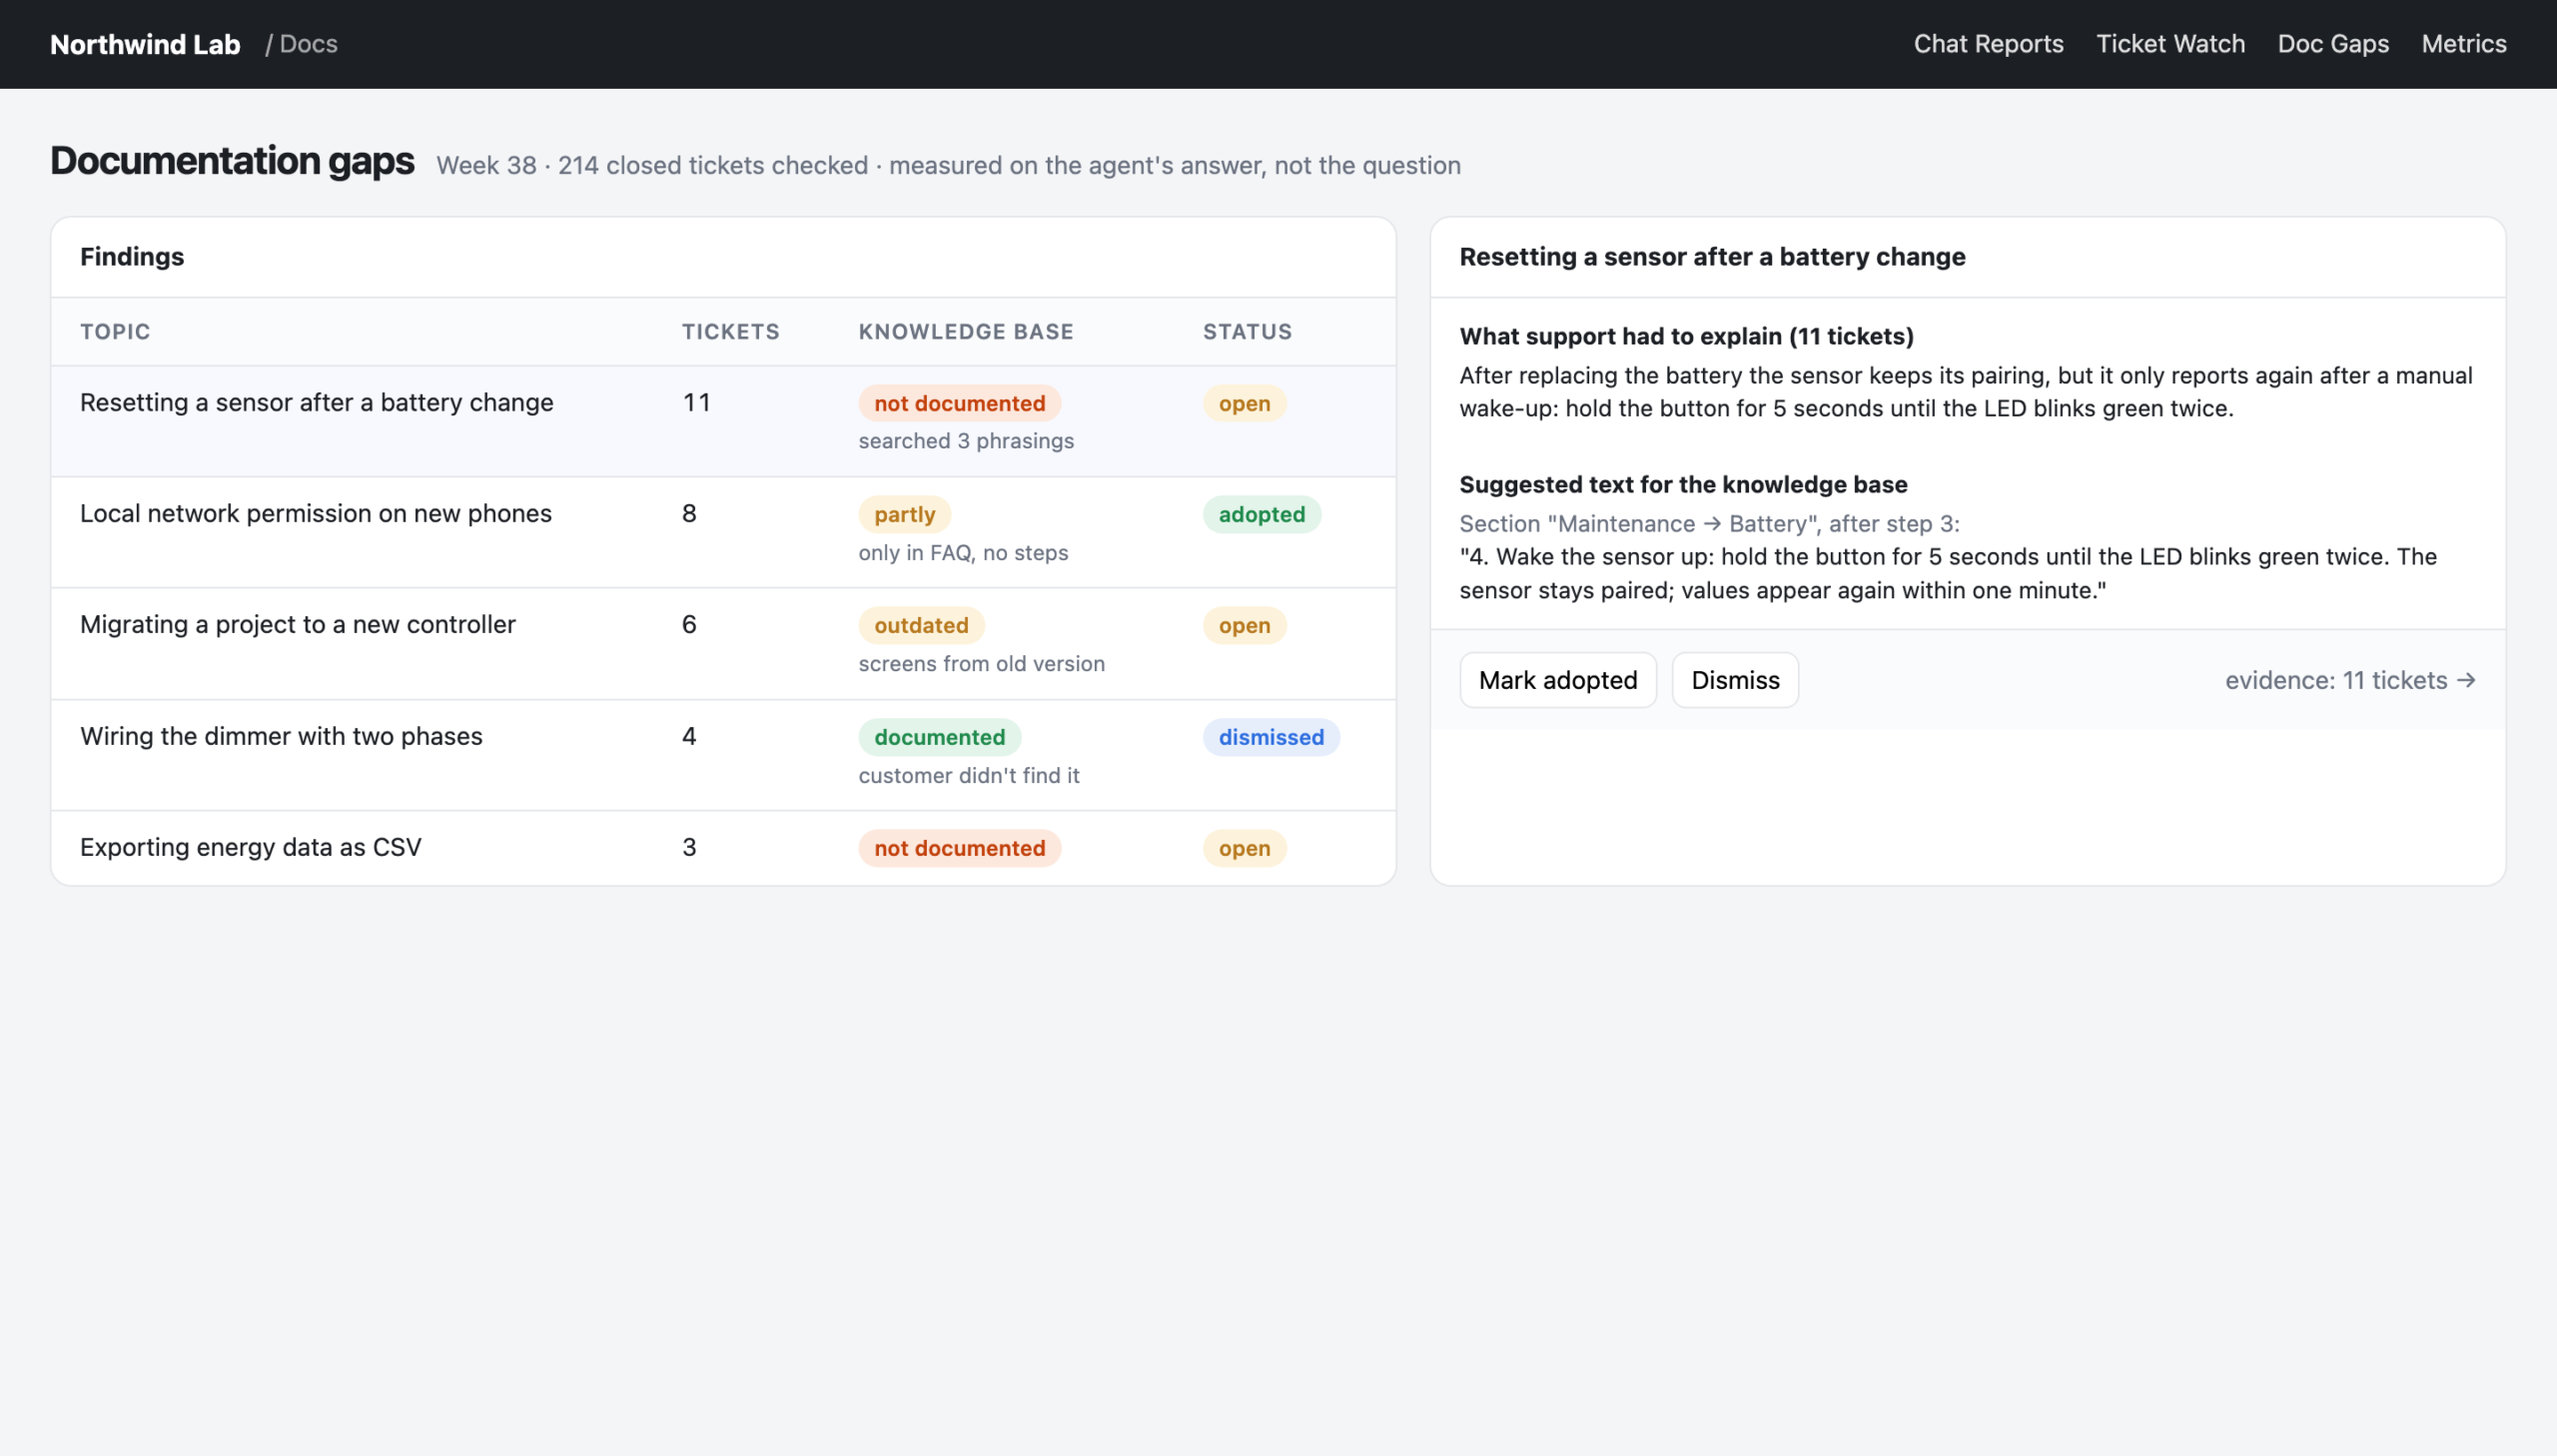
    Doku-Lücken aus Support-Antworten, mit Textvorschlag
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Erkenntnis 1: Das Tempo war nie das Problem

    Als wir angefangen haben, unsere Live-Chats zu bewerten, habe ich langsame Reaktionszeiten erwartet. Alle beschweren sich übers Warten im Chat.

    Falsch. Wenn jemand einen Chat angenommen hat, dann innerhalb von Sekunden. Das Problem war, dass zu viele Chats gar nicht angenommen wurden. Es ging um Abdeckung, nicht um Tempo.

    Das ist ein ganz anderes Problem mit einer ganz anderen Lösung: Schichtplanung statt Schulung. Seit es jeden Morgen sichtbar war, ist der Anteil der angenommenen Chats innerhalb weniger Wochen deutlich gestiegen. Niemandem musste man sagen, dass er sich beeilen soll. Die Zahl musste nur auf dem Tisch liegen.

    Erkenntnis 2: Die Stille nach der ersten Antwort

    Dasselbe Muster haben wir bei den Support-Tickets gesehen. Wir haben mit einer Zufallsstichprobe von hundert abgeschlossenen Tickets angefangen, um die Realität zu sehen, bevor wir irgendetwas bauen. Die ersten Antworten kamen schnell. Aber ein spürbarer Anteil der Tickets wurde geschlossen, ohne dass der Kunde eine echte Antwort bekommen hatte, und manche lagen mitten im Gespräch fast zwei Wochen still.

    Das Tempo stimmte. Die Stille danach nicht.

    Also haben wir eine kleine Beobachtungsliste gebaut: offene Tickets, bei denen die letzte Nachricht vom Kunden kommt und seit Tagen niemand geantwortet hat. Das ist keine Analyse, das ist eine To-do-Liste. Und es ist eine der meistgenutzten Seiten, die wir haben.
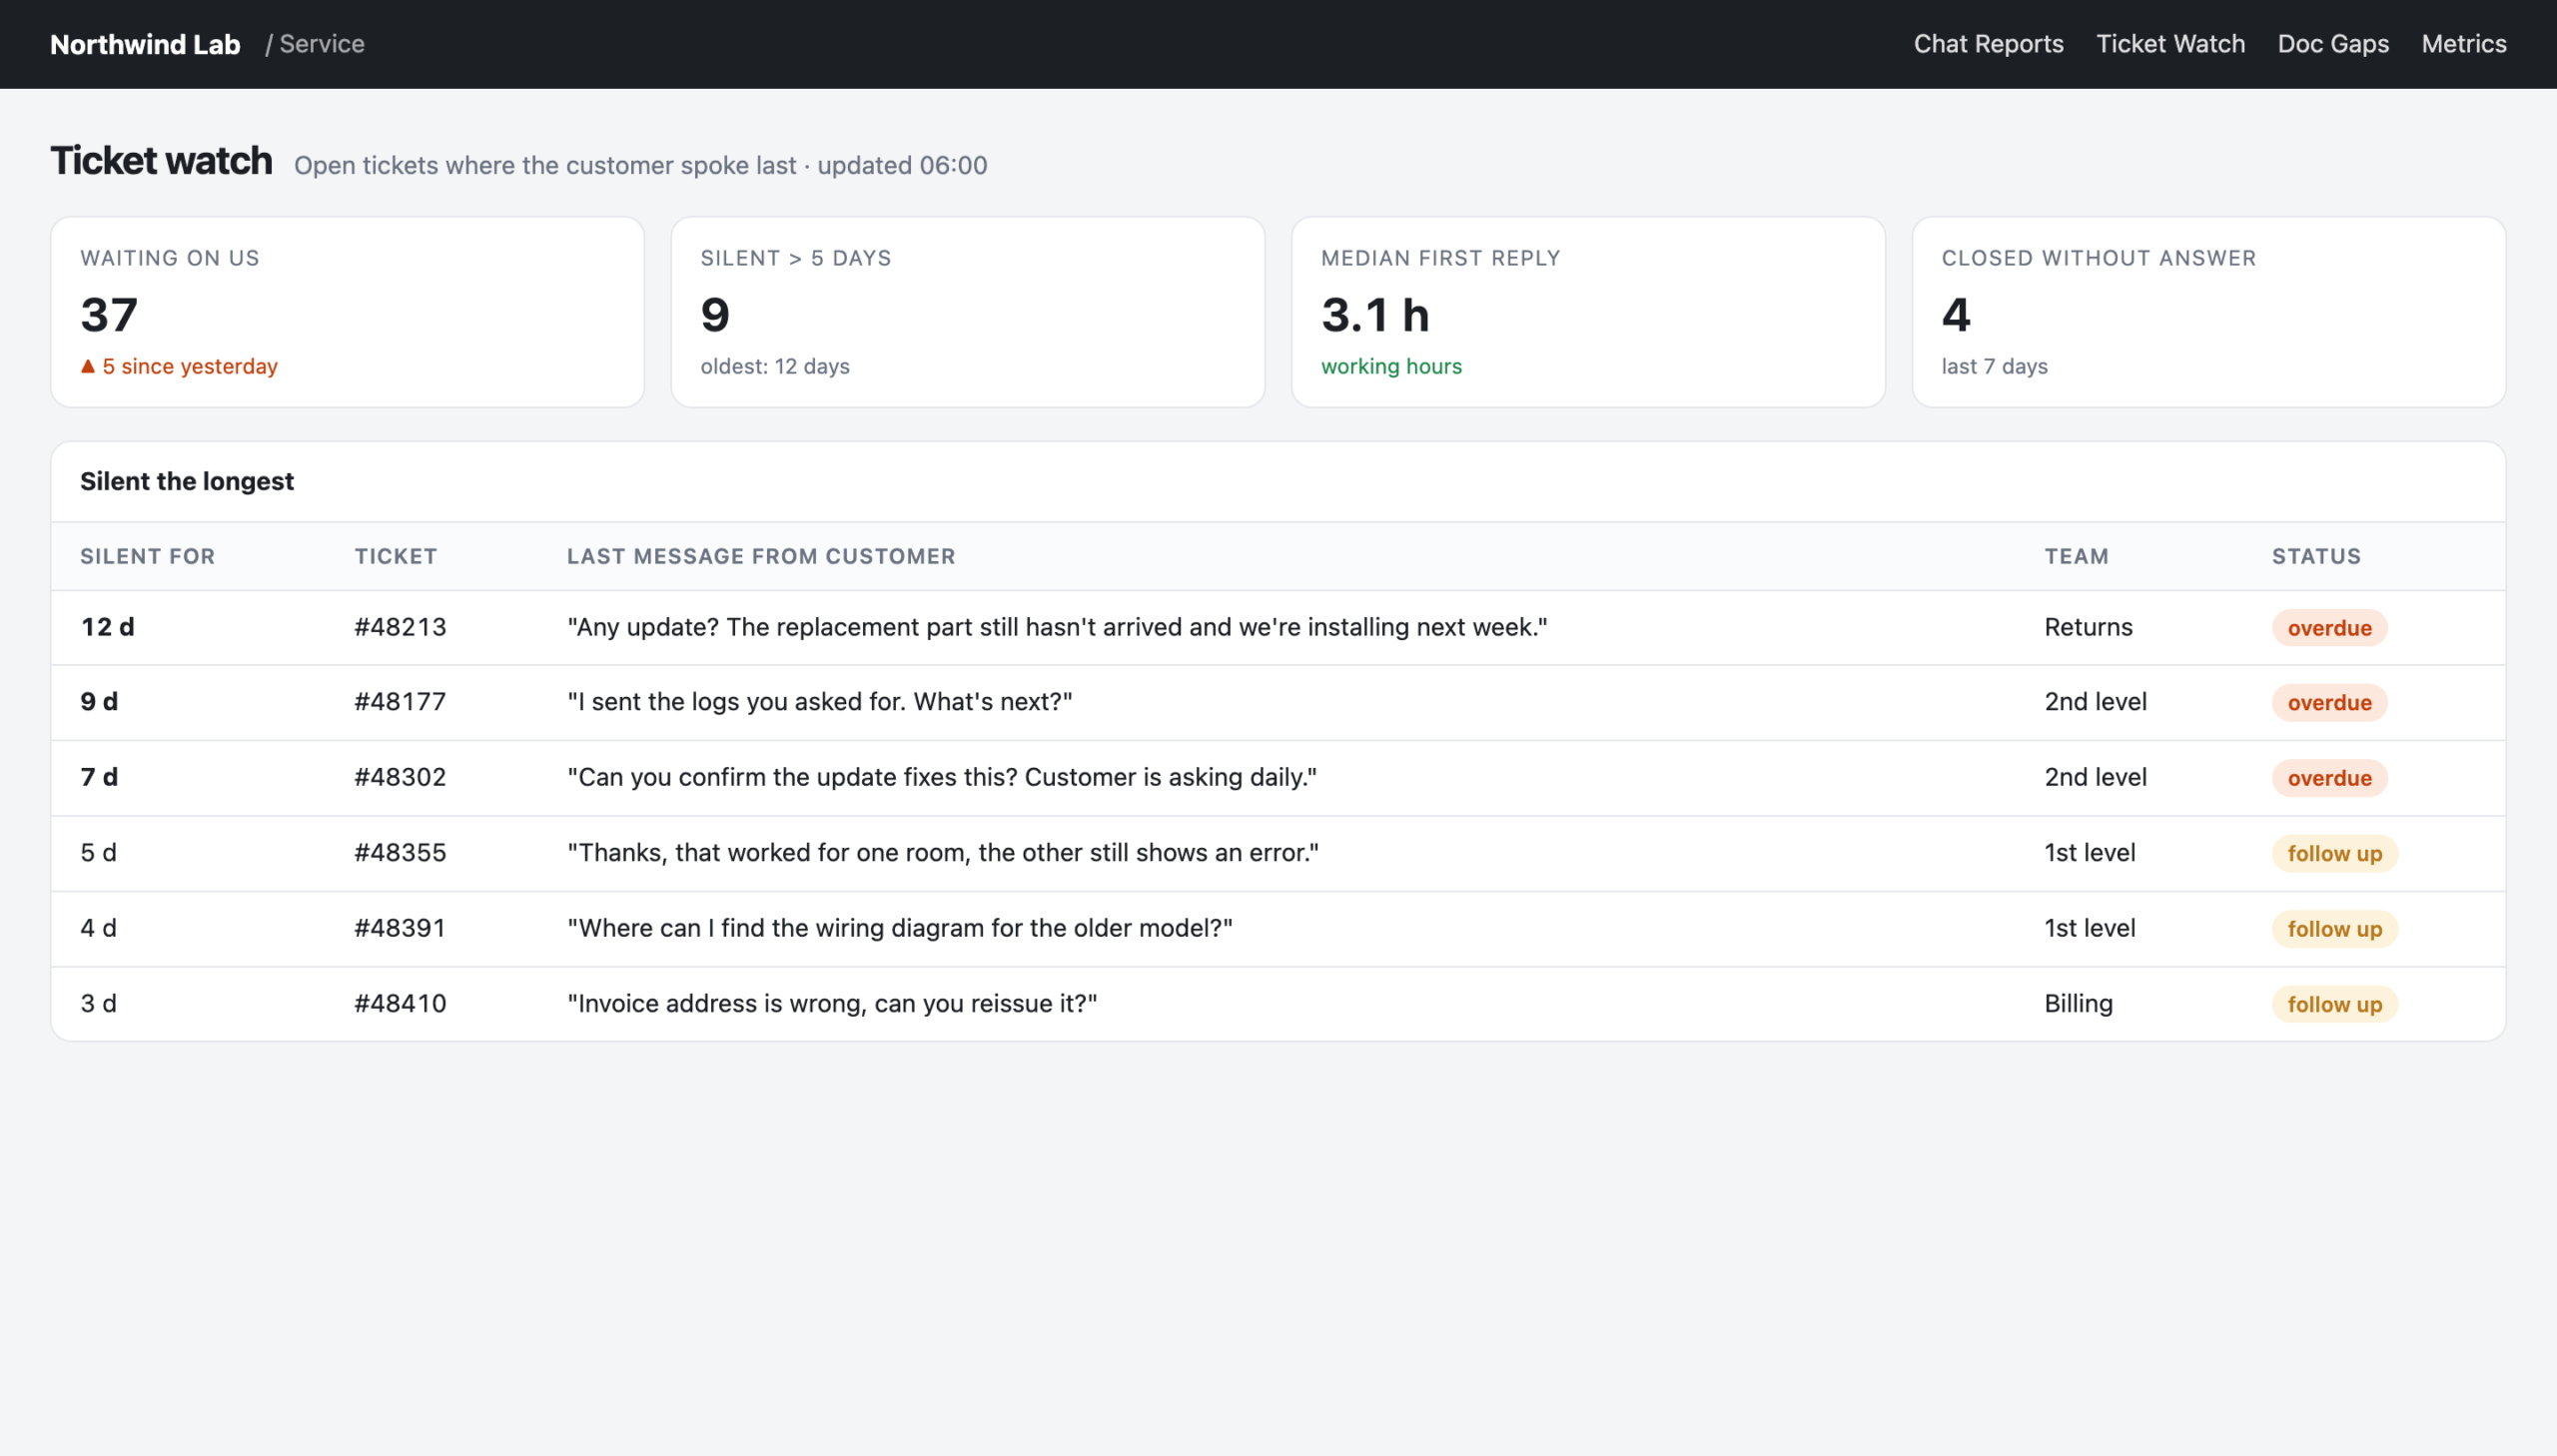
    Ticket-Watch: offene Tickets, in denen der Kunde zuletzt geschrieben hat
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Erkenntnis 3: „Beantwortet“ heißt nicht beantwortet

    In unserer Social-Media-Analyse wollten wir wissen, wie gut wir auf Kommentare und Direktnachrichten antworten. Das Analytics-Tool sagte: auf fast alle.

    Als wir genauer hingeschaut haben, waren die meisten dieser „Antworten“ automatische Nachrichten, die innerhalb einer Minute verschickt wurden. Ein Mensch hatte sie nie gesehen. Heute behandeln wir jede Antwort der Marke innerhalb von sechzig Sekunden als Auto-Reply und listen die Leute auf, die noch auf eine echte Antwort warten.

    Die Lektion lässt sich verallgemeinern: Wann immer dir ein Tool eine verdächtig gute Zahl liefert, prüf, wie sie gezählt wurde.

    Warum das Aufgabe des Marketings ist

    Man könnte sagen, das ist alles Kundenservice. Es ist aber nicht nur das. Was Kunden im Support fragen, ist das, wonach sie vor dem Kauf suchen werden. Was der Support erklären muss, ist das, was deine Website, deine Produktseiten und dein Content nicht erklären. Wo Kunden hängen bleiben, macht deine Kommunikation ein Versprechen, das das Produkterlebnis nicht hält.

    Es ist außerdem das beste Content-Briefing, das du je bekommen wirst. Jede Erklärung, die der Support immer wieder schreibt, ist ein Blogbeitrag, ein Video oder ein Hilfeartikel, der darauf wartet, geschrieben zu werden, und zwar gleich mit dem genauen Wortlaut der Kunden.

    So fängst du an

    1. Lies zuerst selbst eine Stichprobe. Nimm hundert zufällige Gespräche und lies sie. Danach weißt du, was du messen willst, und du erkennst, wenn die KI danebenliegt.
    2. Stell das vollständige Gespräch neben jedes KI-Urteil. Die Leute müssen nachprüfen können.
    3. Miss die Antwort, nicht die Frage, wenn du Lücken im Content suchst.
    4. Mach aus Erkenntnissen Listen, keine Diagramme. „Diese zwölf Kunden warten“ ist nützlicher als eine Trendlinie.
    5. Sei misstrauisch bei guten Zahlen. Prüf, wie sie gezählt werden.

    Deine Kunden sagen dir längst, was du reparieren und was du schreiben sollst. Neu ist nur, dass du es dir endlich leisten kannst, allen zuzuhören.
  • Mach deine KI widersprechbar

    Mach deine KI widersprechbar

    Vor ein paar Wochen hatten unsere KI-bewerteten Chat-Reports ein Problem. Jeden Morgen markierte der Report eine Handvoll „verpasster Verkaufschancen“ in unseren Live-Chats. Und jeden Morgen schaute sich unser Vertriebsteam die Fälle an und sagte: Nein, das war keine Chance. Dieser Kunde hatte schon einen Partner. Diese Frage war rein technisch.

    Die KI war nicht dumm. Sie lag jeden Tag auf dieselbe Weise selbstbewusst falsch, weil ihr niemand etwas anderes gesagt hat.

    In dem Moment habe ich die wichtigste Designregel für KI-Reports im Marketing verstanden: Eine Analyse, der niemand widersprechen kann, wiederholt ihre Fehler jeden Tag.

    Daumen runter, mit Begründung

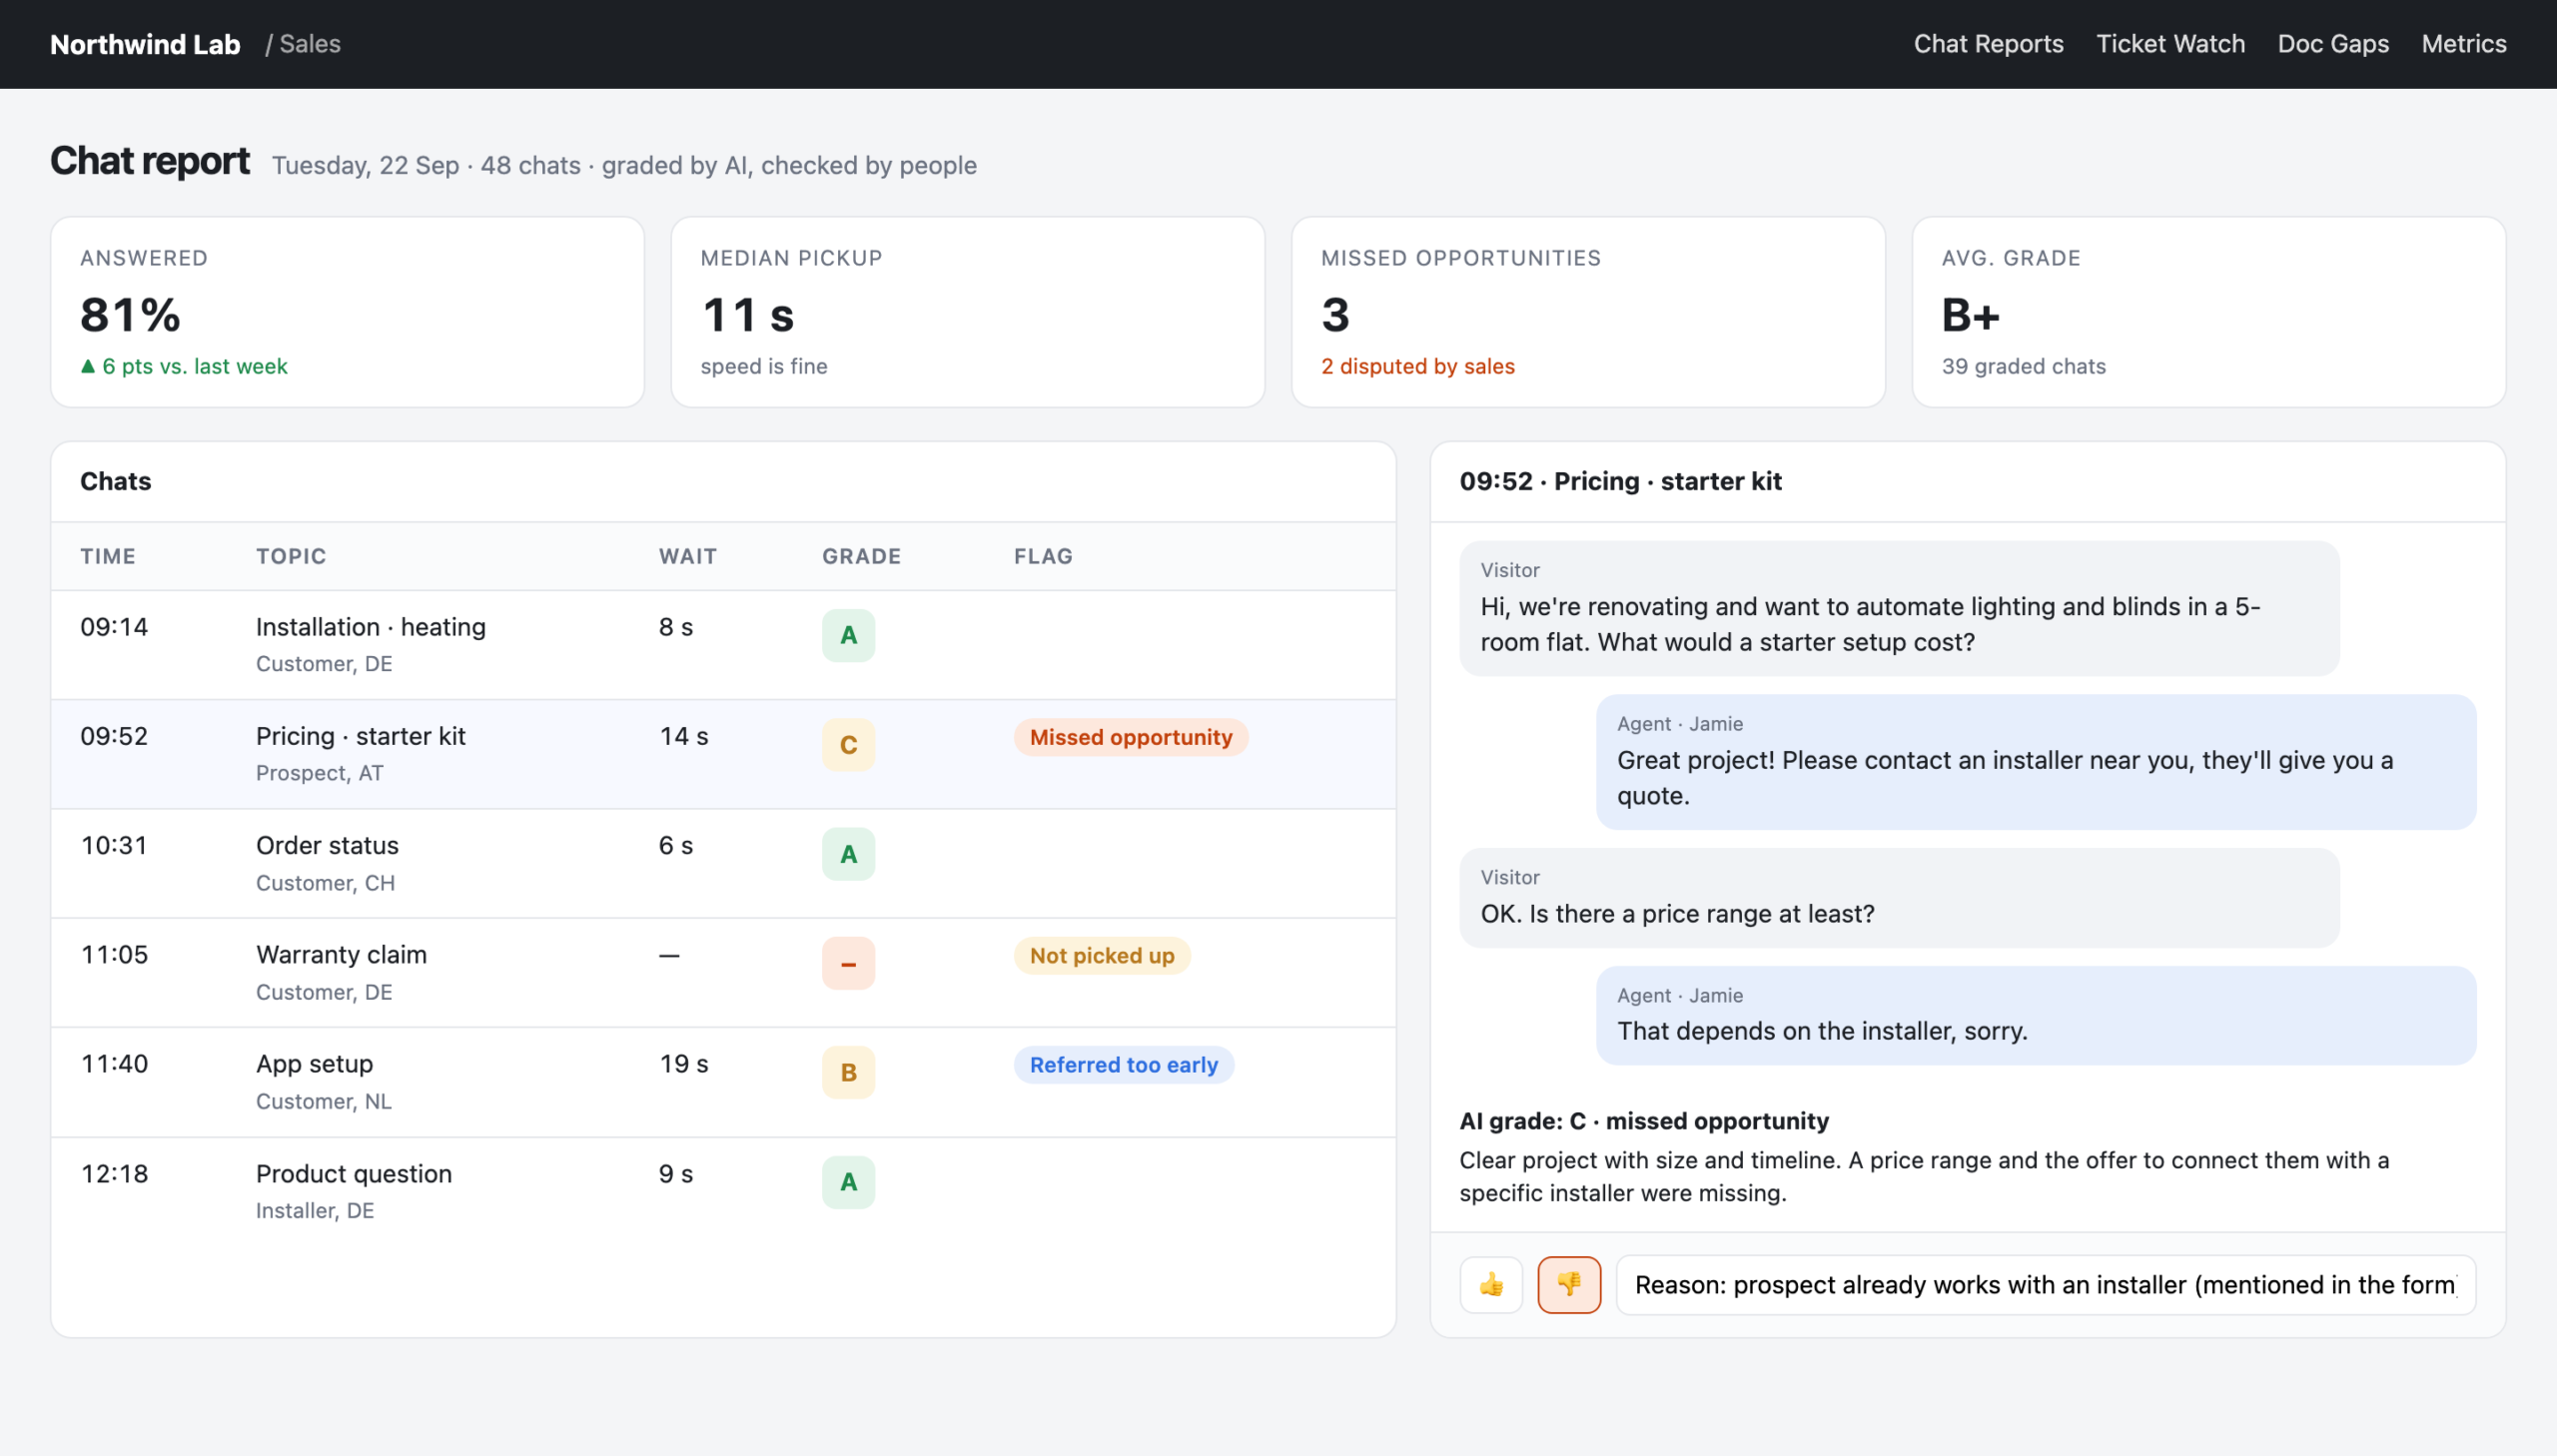
    Die Lösung war fast peinlich einfach. Jede KI-Bewertung in unseren Reports hat jetzt einen Daumen hoch und einen Daumen runter. Für den Daumen runter gibt es eine Bedingung: Du musst eine Begründung schreiben. Ein Satz reicht. „Kunde arbeitet schon mit einem Partner.“ „Das war eine Support-Frage, kein Sales-Lead.“

    Der Durchlauf am nächsten Tag liest diese Begründungen, bevor er irgendetwas bewertet. Die Fehler verschwinden nicht über Nacht, aber sie wiederholen sich nicht mehr. Und genauso wichtig: Das Vertriebsteam hat aufgehört, den Report zu ignorieren, weil es jetzt eine Möglichkeit hatte, ihn mitzugestalten.

    Zwei Dinge habe ich dabei gelernt:

    Chat-Report: von der KI bewertete Chats, das Transkript direkt neben der Note
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.
    • Die Begründung zählt mehr als die Stimme. Ein Daumen runter allein sagt der KI, dass sie falschlag, aber nicht warum. Ohne das Warum wird sie einfach überall vorsichtiger.
    • Feedback ist auch ein Vertrauenssignal. Einem Report, mit dem die Leute streiten können, vertrauen sie viel mehr als einem polierten, bei dem das nicht geht.

    Lass die KI keine Kategorien erfinden

    Die zweite Lektion kam von den Themen-Labels. Wir ordnen jeden Chat und jedes Ticket einem Thema zu, damit wir sehen, wonach Kunden am häufigsten fragen. Für einen Durchlauf habe ich den KI-Sub-Agenten eine Liste mit Beispielthemen mitgegeben, als kleine Hilfe.

    Sie haben sie als Inspiration verstanden. Zurück kamen fünfzehn neue, erfundene Labels, alle leicht unterschiedlich, die ich dann von Hand wieder unseren echten Kategorien zuordnen musste. Ein Trenddiagramm auf Basis von Labels, die sich von Durchlauf zu Durchlauf ändern, ist wertlos.

    Die Regel lautet jetzt: Die Labels sind eine geschlossene Liste. Passt ein Gespräch nicht dazu, antwortet der Sub-Agent mit „Sonstiges“ und ergänzt einen Vorschlag. Am Ende des Durchlaufs schaut sich die Hauptsession alle Vorschläge auf einmal an und entscheidet, ob sich ein neues Label lohnt. Von den ersten acht Vorschlägen wurden drei zu echten Labels. Die anderen fünf waren Varianten bestehender.

    Wenn du Zahlen über die Zeit vergleichen willst, gilt: Die KI darf Kategorien befüllen, aber nicht festlegen.

    Ablehnen statt raten

    Wir haben außerdem einen Dokumentations-Bot gebaut, der Produktfragen aus unserer Wissensdatenbank beantwortet. Bevor wir ihn auf Kunden losgelassen haben, haben wir ihn mit 200 echten Fragen aus Support-Tickets getestet und die Antworten von einem anderen Modell beurteilen lassen.

    Das Ergebnis war ernüchternd und nützlich. Nur ein kleiner Teil der Antworten war vollständig richtig. Die meisten waren teilweise richtig: hilfreich, um jemanden zum passenden Artikel zu schicken, aber unvollständig. Ein paar Prozent waren falsch, und eine war eine echte Halluzination: ein Befehl, den es gar nicht gibt.

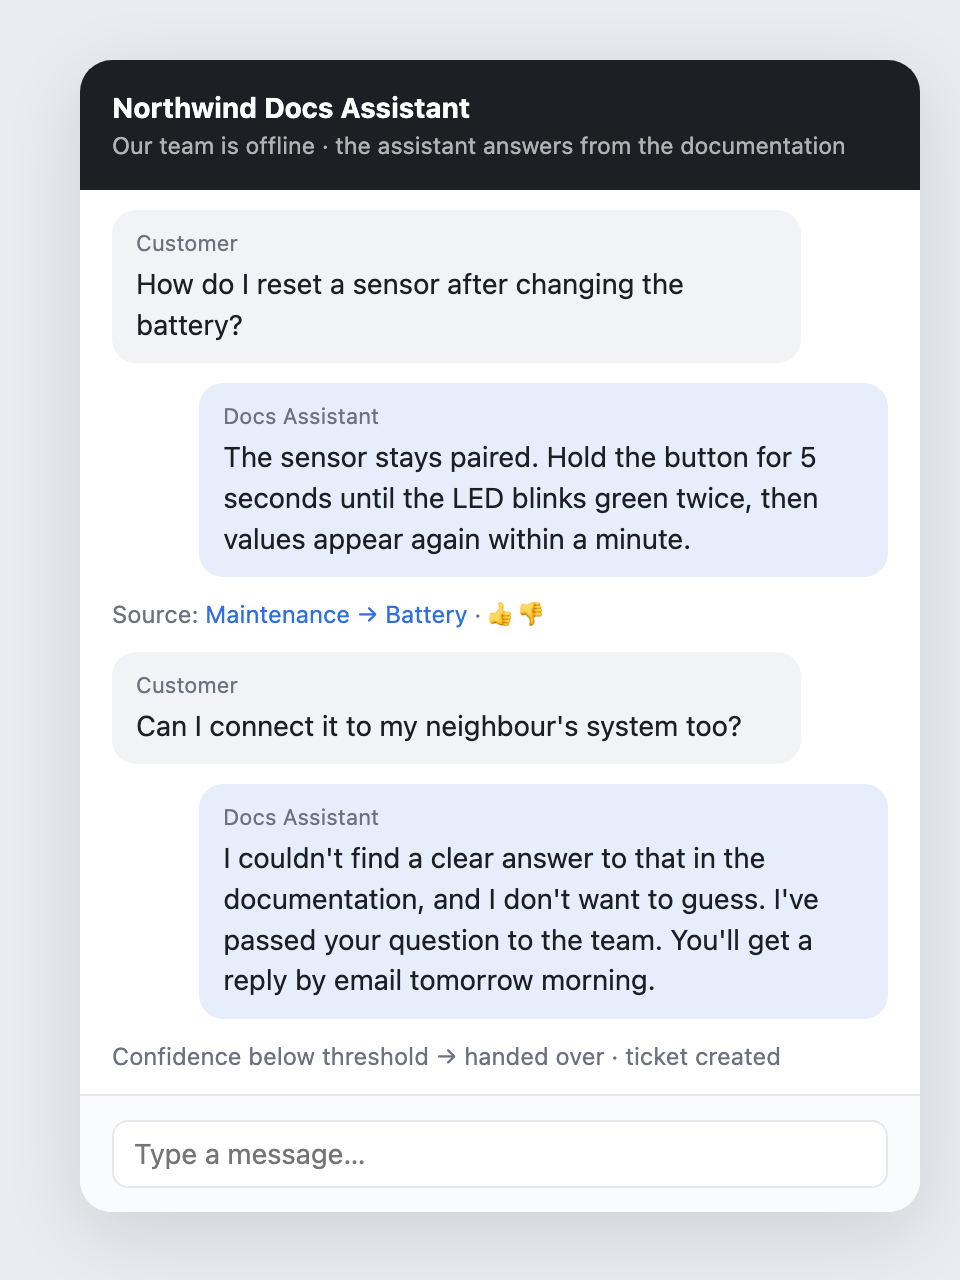
    Wir haben den Bot nicht aufgegeben. Wir haben seine Aufgabe geändert. Er ist jetzt ein Wegweiser durch die Dokumentation, kein Ersatz für den Support. Und wir haben eine Konfidenzschwelle eingebaut: Deckt die gefundene Dokumentation die Frage nicht eindeutig ab, sagt der Bot, dass er es nicht weiß, und übergibt. Ein ehrliches „Weiß ich nicht“ ist mehr wert als eine flüssige falsche Antwort.

    Der Doku-Bot antwortet mit Quelle und übergibt, wenn er unsicher ist
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Dasselbe Prinzip gilt für unsere Analyse-Tools. Eine unserer Regeln für den Report zu Dokumentationslücken: Behaupte nie, etwas sei „nicht dokumentiert“, ohne mit mindestens zwei unterschiedlichen Formulierungen danach gesucht zu haben. Kunden und die Leute, die Dokumentation schreiben, verwenden selten dieselben Wörter.

    Abbrechen, nicht erfinden

    Viele unserer Reports laufen jeden Morgen automatisch, ohne dass jemand zuschaut. Deshalb ist eine Regel nicht verhandelbar: Fehlen Daten oder bricht eine Verbindung ab, stoppt der Durchlauf und sagt das auch. Er füllt die Lücken nicht mit plausiblen Zahlen.

    Klingt selbstverständlich. Ist es nicht. Der Instinkt eines Sprachmodells ist, hilfreich zu sein, und „hilfreich“ heißt bei fehlenden Daten: etwas erfinden. Du musst ihm ausdrücklich und schriftlich sagen, dass ein abgebrochener Report besser ist als ein erfundener.

    Den Beleg direkt neben das Urteil

    Das letzte Muster ist das einfachste. Jede Bewertung, jedes markierte Ticket, jede Content-Idee in unseren Tools verlinkt zurück auf die Quelle: das vollständige Chat-Protokoll, das tatsächliche Ticket, die echten Instagram-Kommentare, auf denen eine Idee beruht. Jeder kann durchklicken und nachprüfen.

    Das bewirkt zweierlei. Fehler werden schnell sichtbar. Und die Menschen behalten die Gewohnheit, sich die echten Gespräche anzuschauen, wo die eigentlichen Erkenntnisse ohnehin liegen.

    Eine Checkliste für deine eigenen KI-Reports

    Wenn du KI-gestützte Reports im Marketing baust, würde ich das hier vom ersten Tag an einbauen:

    1. Ein Daumen runter, der eine Begründung verlangt, und ein nächster Durchlauf, der sie liest.
    2. Geschlossene Listen für alles, was du über die Zeit zählen willst. „Sonstiges plus Vorschlag“ statt erfundener Labels.
    3. Eine Konfidenzschwelle. Ablehnen statt raten.
    4. Abbruch bei fehlenden Daten. In den Anweisungen festgeschrieben, nicht vorausgesetzt.
    5. Ein Beleg neben jedem Urteil. Ein Link zur Quelle, immer.

    Bei alldem geht es nicht um bessere Modelle. Es geht darum, die Arbeit der KI zu etwas zu machen, das Menschen prüfen, anzweifeln und verbessern können. Genau das macht aus einer beeindruckenden Demo ein Tool, auf das sich ein Team wirklich verlässt.

  • Dein erfolgreichster Post lügt dich an

    Dein erfolgreichster Post lügt dich an

    „Welche unserer Posts funktionieren am besten, und wovon sollten wir mehr machen?“

    Das ist die naheliegendste Frage, die du einer KI zu deinen Social-Media-Kanälen stellen kannst. Es ist aber auch eine Frage, bei der die KI komplett und selbstbewusst danebenliegen kann und dir Empfehlungen gibt, die genau in die falsche Richtung zeigen.

    Uns ist genau das passiert. Hier ist, wie es dazu kam, und welche Regeln wir seitdem befolgen.

    Das Quartal, das keines war

    Als ich zum ersten Mal einen Agenten unsere Performance auf YouTube und Instagram analysieren ließ, sahen die Ergebnisse großartig aus. Ein Quartal stach mit Abstand als unser stärkstes heraus, mit durchschnittlich um ein Vielfaches mehr Aufrufen pro Video als in jedem anderen Quartal. Die Empfehlung der KI: mehr von dem machen, was wir damals gemacht haben.

    Das Problem: In diesem Quartal liefen zwei große Kampagnenfilme mit ordentlich Mediabudget dahinter. Die haben nicht „performt“. Für ihre Sichtbarkeit wurde bezahlt. Als wir sie herausgenommen haben, fiel der Durchschnitt für dieses Quartal ungefähr auf ein Zehntel, und es stellte sich heraus, dass es unser schwächstes Quartal war, nicht unser bestes.

    Jede Empfehlung auf Basis der ersten Version wäre falsch gewesen. Und sie hätte vollkommen plausibel ausgesehen, mit Diagrammen und allem Drum und Dran.

    Regel 1: Trenn bezahlt von organisch, bevor du irgendetwas rankst. Nicht als Fußnote, nicht als Filter, den man optional setzen kann. Als ersten Schritt, jedes Mal. Wir nennen das inzwischen unsere eiserne Regel, und sie steht in den Analyse-Anweisungen, damit kein Agent sie überspringen kann.

    Ein Ausreißer lässt alles andere schlecht aussehen

    Selbst nachdem wir die Kampagnen entfernt hatten, stießen wir auf ein zweites Problem. Ein beworbenes Video hatte so viele Aufrufe, dass daneben jedes normale Video winzig wirkte. In einem Ranking nach Durchschnittswerten sah ein ganz normales gutes Video mehr als hundertmal schlechter aus als der Spitzenreiter. Das ist keine Erkenntnis, das ist Rauschen.

    Wir sind auf Mediane umgestiegen. Der Median zeigt dir, was ein typischer Post leistet. Den einen Post, der viral gegangen ist oder beworben wurde, ignoriert er. Plötzlich wurden die Unterschiede zwischen Formaten und Themen wieder sichtbar: welche Arten von Posts verlässlich etwas besser laufen und welche verlässlich etwas schlechter.

    Regel 2: Nimm den Median für „typisch“, und schau dir Ausreißer getrennt an. Ausreißer sind interessant. Sie sollten nur nicht deine Basislinie bestimmen.

    „Engagement“ ist nicht gleich Engagement

    Unterschiedliche Plattformen zählen unterschiedliche Dinge. Auf einem Netzwerk enthielt das „Engagement“ im Analytics-Tool auch Link-Klicks, auf einem anderen nicht. Legst du sie nebeneinander, wirkt eine Plattform aus rein technischen Gründen viel ansprechender als die anderen.

    Regel 3: Vergleich innerhalb einer Plattform, nicht plattformübergreifend, außer du hast geprüft, dass die Zahlen dasselbe bedeuten.

    Eine Kennzahl, drei Definitionen

    Dasselbe Problem gibt es auch in Unternehmen. Für eine unserer zentralen Geschäftskennzahlen haben wir drei verschiedene Definitionen gefunden, die im Umlauf waren, in drei verschiedenen Präsentationen. Jede war vertretbar. Zusammen führten sie dazu, dass jedes Meeting mit einer Debatte darüber begann, wessen Zahl stimmt.

    Gelöst haben wir es, indem wir die Definition einmal aufgeschrieben haben, an einem einzigen Ort, und ein kleines Tool gebaut haben, das sie live aus dem CRM berechnet. Niemand muss der Definition für immer zustimmen. Aber alle verwenden dieselbe, bis sie geändert wird, an genau diesem einen Ort.

    Regel 4: Jede Kennzahl hat genau eine schriftliche Definition. Vor allem, wenn eine KI rechnet. Sie nimmt die Definition, die sie zuerst findet.

    Achte aufs Kleingedruckte

    Ein paar weitere Fallen, in die wir getappt sind:

    • Währungen. Als wir den Partnerumsatz über Länder hinweg mit einem einzigen Schwellenwert verglichen haben, wirkten Partner in Ländern mit einer anderen Währung um ein Vielfaches größer, als sie waren. Rechne immer um, bevor du vergleichst.
    • Auto-Replies. „95 % der Nachrichten beantwortet“ kann heißen: „95 % der Leute haben eine automatische Nachricht bekommen.“ Schau dir an, wie schnell die Antworten kamen.
    • Datenschutz in den Daten. Manche Analytics-Exporte enthalten Links zu Profilbildern mit Zugriffstokens darin. Entferne die, bevor irgendetwas gespeichert oder angezeigt wird.

    Lass die KI zählen, nicht denken

    Das alles heißt nicht, dass KI schlecht in Analytics ist. Bei den mühsamen Teilen ist sie hervorragend: Daten aus APIs holen, sie bereinigen, das Sentiment Tausender Kommentare bewerten, Content-Ideen entwerfen, die auf die echten Posts und Kommentare verlinken, aus denen sie stammen.

    Aber sie hat keine Ahnung, dass für einen Post bezahlt wurde, dass eine Plattform anders zählt oder dass dein Unternehmen eine Kennzahl auf eine bestimmte Weise verwendet. Sie liefert so oder so einen schönen, selbstbewussten Report.

    Die Checkliste ist also kurz:

    1. Bezahltes zuerst raus. Immer.
    2. Mediane für die Basislinie, Ausreißer extra.
    3. Vergleich Gleiches mit Gleichem.
    4. Eine Definition pro Kennzahl, einmal aufgeschrieben.
    5. Lies ein paar der Top-Posts selbst, bevor du dem Ranking glaubst.

    Dein erfolgreichster Post ist vielleicht wirklich dein bester. Stell nur sicher, dass er es sich verdient hat.