Kategorie: KI-Workflows

  • Das Lab: warum Marketing seine eigenen Tools bauen sollte

    Das Lab: warum Marketing seine eigenen Tools bauen sollte

    Den größten Teil meines Berufslebens lief ein neues Tool im Marketing so ab: Lastenheft schreiben, auf einen Slot in der IT warten, auf Budget warten, sechs Monate später etwas bekommen, das fast macht, was du gebraucht hättest. Oder ein SaaS-Produkt kaufen, das 80 % davon kann und die restlichen 20 % unmöglich macht.

    Vor einem Monat haben wir etwas anderes probiert. Wir haben das gestartet, was wir das Lab nennen: ein internes Portal, in dem Marketing- und Vertriebsteams mit KI-Coding-Agenten ihre eigenen Tools bauen. Niemand von uns ist Entwickler. Ich kann ein bisschen HTML und CSS, meine Kolleginnen und Kollegen ungefähr gleich viel.

    Nach vier Wochen gibt es im Lab einen täglichen Chat-Qualitätsreport, einen Finder für Dokumentationslücken, eine Seite mit Marktkennzahlen, eine Beobachtungsliste für Kundentickets, bei denen es still geworden ist, einen Social-Media-Analyser und ein Coaching-Tool für unsere Seminarlocation. Für die meisten davon hat es ein oder zwei Tage bis zur ersten brauchbaren Version gedauert.

    In diesem Beitrag geht es darum, wie das funktioniert, und warum die wichtigste Zutat nicht das KI-Modell ist.

    Der Agent ist der einfache Teil

    Moderne Coding-Agenten schreiben sehr guten Code. Das ist nicht mehr der Engpass. Der Engpass ist, dass der Agent nichts über dein Geschäft weiß. Er weiß nicht, was ein „qualifizierter Lead“ in deinem Unternehmen bedeutet, in welchem CRM-Feld die Partnerstufe steht, warum die Instagram-Zahlen vom letzten Quartal seltsam aussehen oder dass dein Support-Team Tickets auf eine bestimmte Art schließt.

    Gib einem Agenten eine vage Aufgabe und keinen Kontext, und du bekommst ein generisches Dashboard, das toll aussieht und die falsche Frage beantwortet. Gib ihm den richtigen Kontext, und er baut etwas, das sich anfühlt, als hätte es jemand gemacht, der seit Jahren mit dir zusammenarbeitet.

    Die eigentliche Arbeit im Lab ist also nicht das Prompten. Es ist der Aufbau von Kontext.

    Drei Arten von Kontext

    1. Was wir wissen: einfache Markdown-Dateien. Alles, was die Agenten verstehen müssen, liegt als Textdatei vor. Mein eigenes Wissen halte ich in einem Obsidian-Vault fest: wer wir sind, wie wir über unsere Produkte sprechen, Markenrichtlinien, die für KI-Agenten statt für Designer geschrieben sind, Definitionen unserer Kennzahlen. Zusammenfassungen von Meetings landen jeden Abend automatisch im Vault.

    Jedes Projekt-Repository hat eine Einstiegsdatei, AGENTS.md, die jeder Agent zuerst liest, egal ob Claude Code, Codex oder etwas anderes. Daneben liegt ein docs/-Ordner mit Entscheidungen und Erkenntnissen, jeweils mit Datum und Begründung. Wenn ein Agent oder ein Mensch etwas Nicht-Offensichtliches lernt, wird es dort aufgeschrieben. Nicht in einem Chat. Nicht im Gedächtnis eines einzelnen Tools. Im Repo, wo der nächste Agent es findet.

    Eine Regel hat sich als sehr wichtig herausgestellt: Jede Definition steht an genau einem Ort. Als ich im August meinen Vault aufgeräumt habe, waren unsere Markenfarben an sechs Stellen definiert und ein Prozess an neun Stellen beschrieben. Agenten nehmen fröhlich die Version, die sie zuerst finden.

    2. Was gerade passiert: Live-Verbindungen zu unseren Systemen. Kontext heißt auch Daten. Über MCP-Server (die „USB-Anschlüsse“, über die KI-Agenten mit anderer Software sprechen) und APIs können die Agenten unser CRM, unseren Helpdesk, unseren Live-Chat, unsere Social-Media-Analytics und unsere Produktdatenbank lesen. Ein Tool, das „aktive Partner pro Markt“ anzeigt, verwendet keinen Export vom letzten Monat. Es fragt das CRM ab, wenn es läuft.

    So ist auch eine unserer nützlichsten Seiten entstanden. Dieselbe Kennzahl war in Präsentationen mit drei verschiedenen Definitionen unterwegs. Jetzt gibt es eine Definition, einmal aufgeschrieben, und das Tool berechnet sie live. Die Diskussion hat sich von „Wessen Zahl stimmt?“ zu „Was machen wir jetzt damit?“ verschoben.

    3. Was schiefgegangen ist: Erkenntnisse direkt in den Tools. Jeder Skill und jedes Tool hat seine eigene Liste an Fallen. Zum Beispiel: „Lass nie einen KI-Sub-Agenten Tickets aus dem Helpdesk holen, dabei gehen die Filter verloren und du bekommst eine Million Ergebnisse statt ein paar Hundert.“ Diese Notizen sehen langweilig aus. Sie sind der Grund, warum der zweite Durchlauf eines Tools besser ist als der erste.

    Was wir tatsächlich gebaut haben

    Ein paar Beispiele, damit es konkret wird:

    • Chat-Reports. Jeder Live-Chat vom Vortag wird von einer KI gelesen und bewertet: Wurde er angenommen, wie lange hat der Kunde gewartet, wurde eine Verkaufschance verpasst, wurde der Kunde zu früh weggeschickt. Das vollständige Protokoll steht neben der Bewertung, damit jeder nachprüfen kann.
    • Dokumentationslücken. Abgeschlossene Support-Tickets werden mit unserer öffentlichen Wissensdatenbank abgeglichen. Was der Support schriftlich erklären musste, fehlt wahrscheinlich in der Dokumentation. Das Tool schlägt den Text vor, der ergänzt werden sollte.
    • Social-Analyser. KPIs über unsere Marken-Accounts hinweg, das Sentiment jedes Kommentars und jeder DM, eine Liste der Leute, die noch auf eine Antwort warten, und Content-Ideen, die auf die echten Posts und Kommentare verlinken, aus denen sie stammen. Den Großteil davon hat eine Marketing-Kollegin gebaut, nicht ich.
    • Ticket-Beobachtung. Offene Tickets, bei denen ein Kunde wartet und seit Tagen niemand geantwortet hat.
    • Location-Coaching. Anfragen für unsere Seminarlocation, aus denen keine Buchung wurde, warum nicht, und was sie wert gewesen wären.

    Nichts davon ist ausgefeilte Software. Die Tools sind klein, konkret und von den Leuten gebaut, die sie auch nutzen. Genau darum geht es.
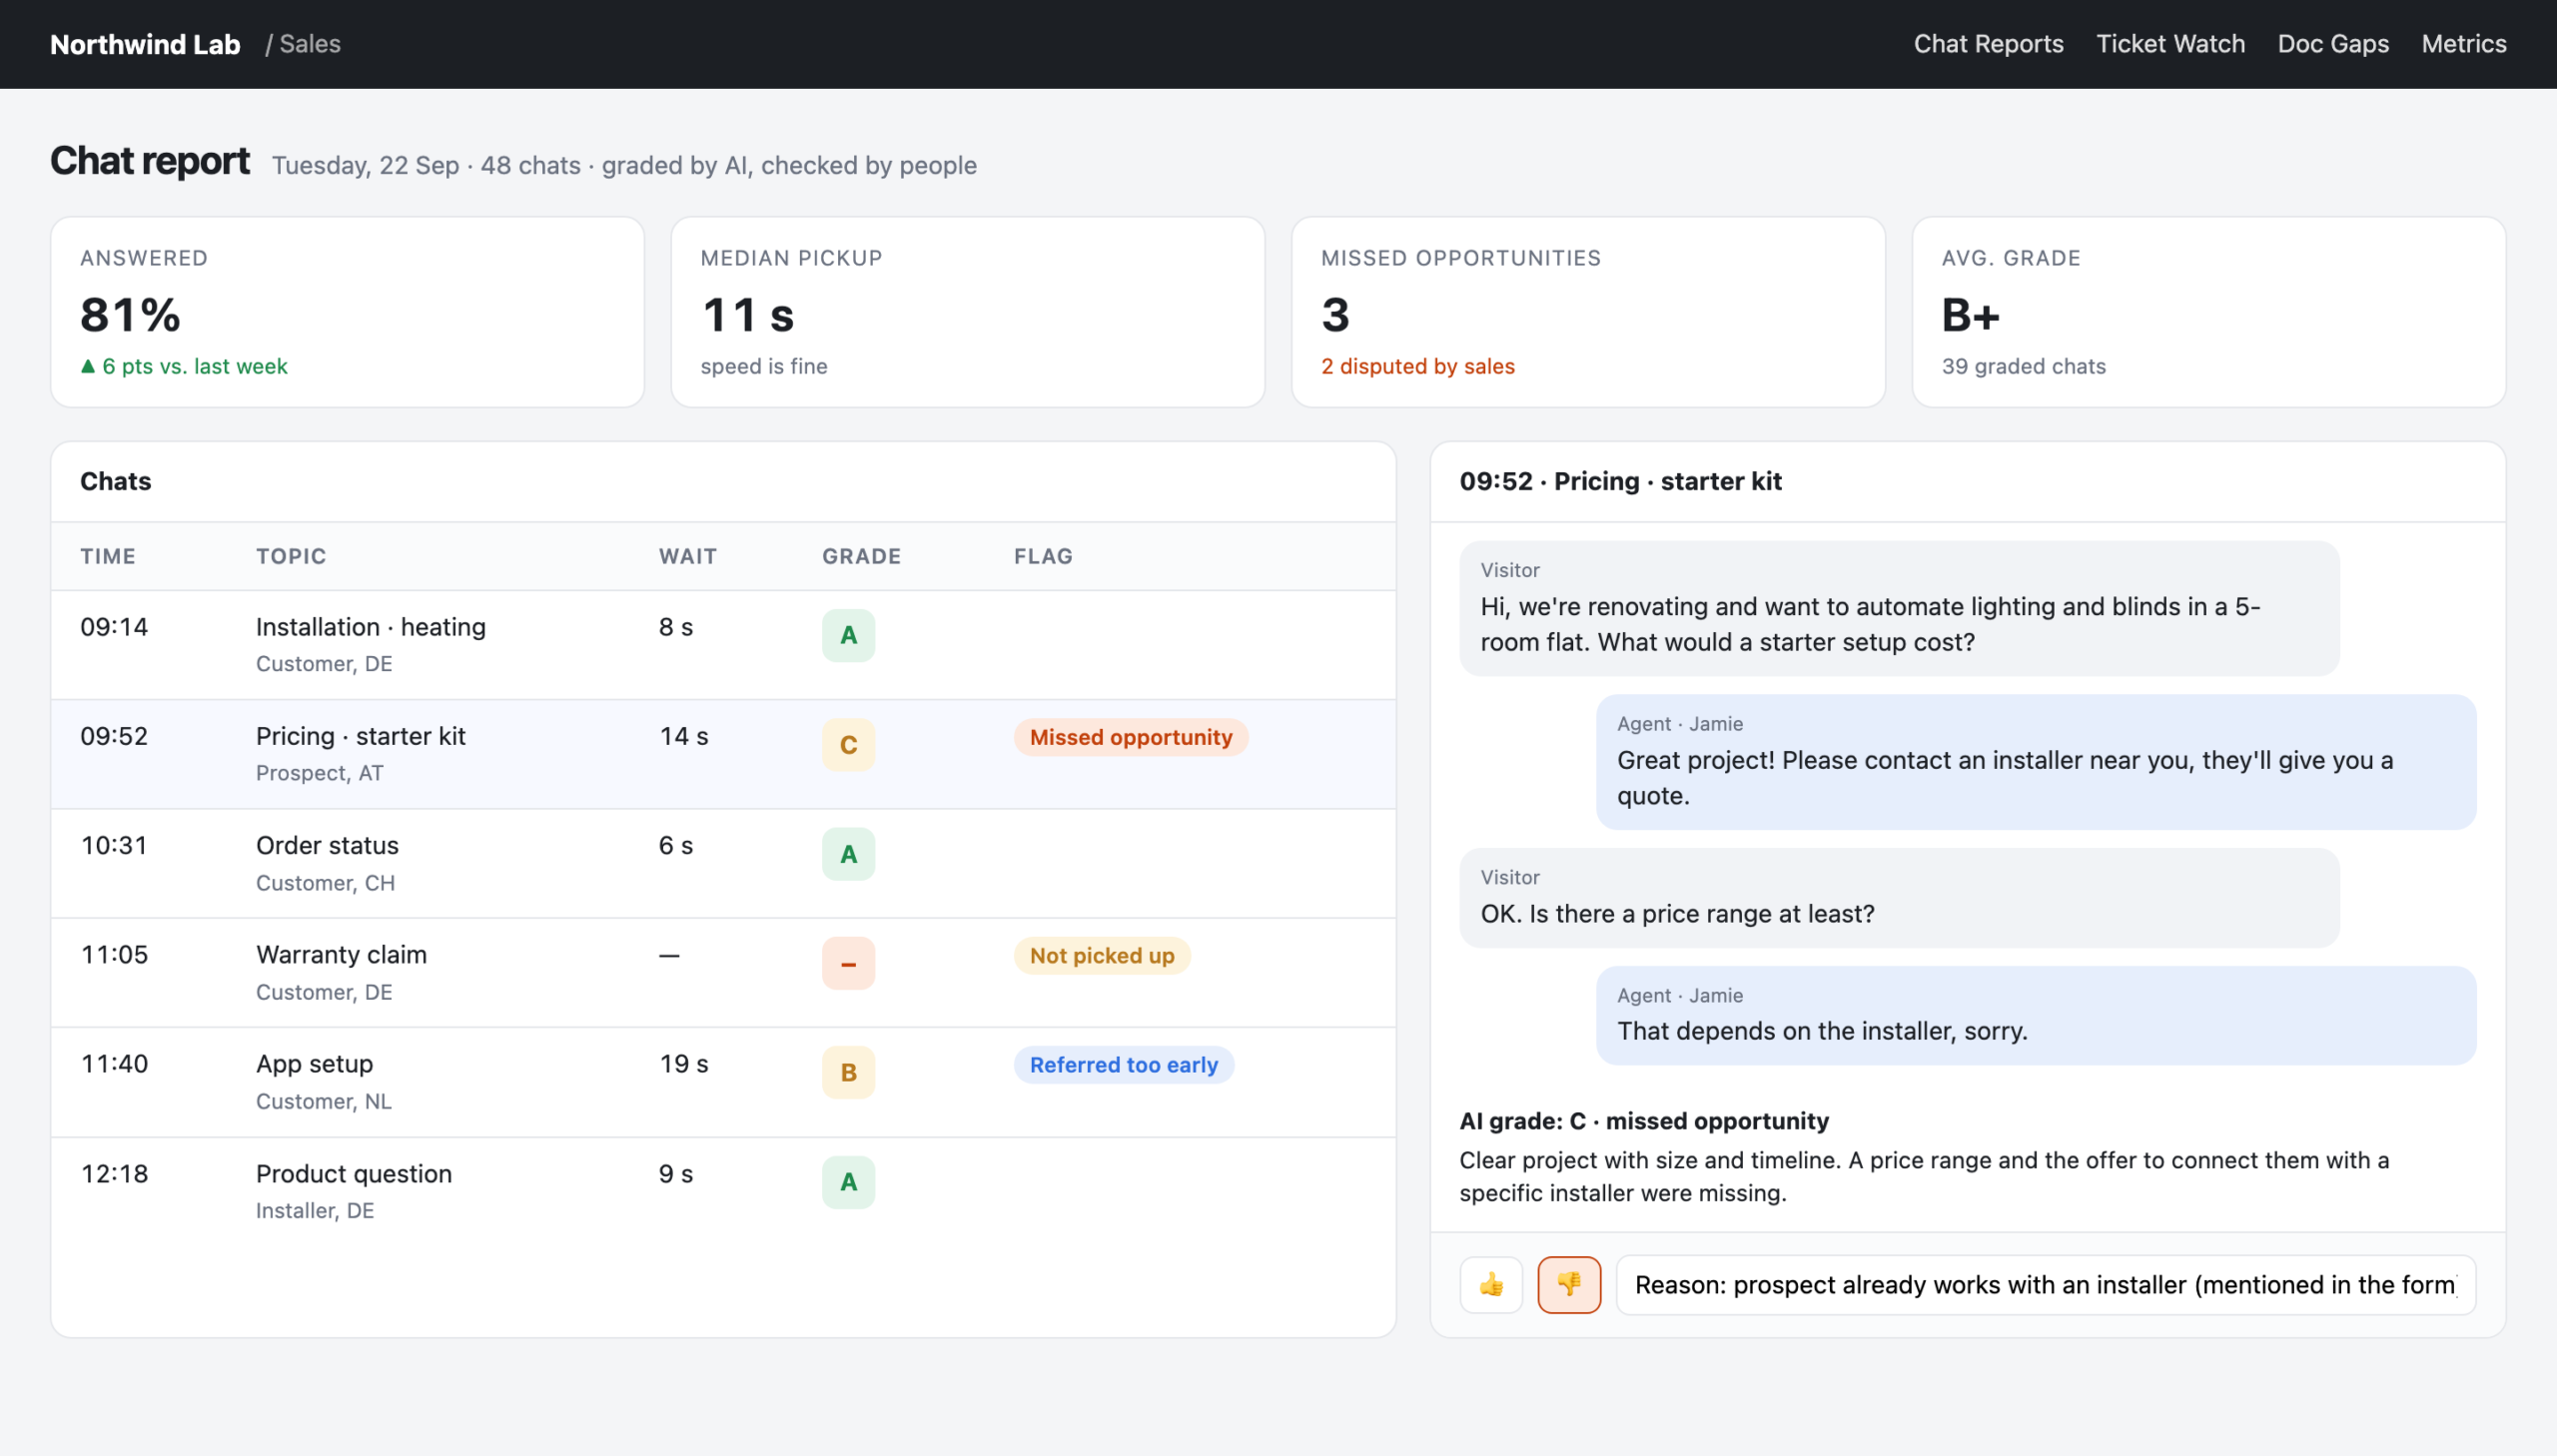
    Chat-Report: von der KI bewertete Chats, das Transkript direkt neben der Note
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Wie Teams unabhängig bleiben (von der IT und voneinander)

    Jedes Team bekommt im Portal seinen eigenen Bereich: seine eigene kleine App, seinen eigenen Pfad, seinen eigenen Deploy. Wenn Marketing etwas kaputtmacht, geht der Bereich von Marketing kaputt, nicht das ganze Portal. Wer neu dazukommt, bekommt eine Einladung und einen „Prompt kopieren“-Button. Der Prompt weist den eigenen KI-Agenten an, das Projekt zu klonen, AGENTS.md zu lesen und die Onboarding-Checkliste abzuarbeiten. Das Wissen bleibt im Repo, der Prompt zeigt nur dorthin.

    Alles läuft auf Cloudflare mit einem Login davor. Nichts ist öffentlich, und niemand musste ein Login-System bauen. Wer etwas ansehen will, braucht nur eine Firmen-E-Mail-Adresse.

    Wir haben uns die Alternativen angeschaut. Ein BI-Tool mit Preis pro Nutzer und ohne Möglichkeit, Daten einzugeben. Ein Plattformprodukt für mandantenfähige Apps, das für drei Teams mehr gekostet hätte, als es wert war. Getrennte Repositories pro Team. Am Ende haben wir die einfachste Variante gewählt, die funktioniert: ein Repository, mehrere Bereiche, Absprache statt Zwang.

    Ist das eine Bedrohung für die IT?

    Nein. Die IT betreibt weiterhin die zentralen Systeme, kümmert sich um Sicherheit und um alles, was grundsolide sein muss. Was sich ändert, ist der Long Tail: die Hunderten kleinen Reports, Prüfungen und Helfer, die nie wichtig genug für ein IT-Projekt waren, aber die Woche eines Marketingteams spürbar verändern.

    Dafür lautete die Antwort bisher „Lebt ohne“ oder „Baut es in Excel“. Die neue Antwort ist: Bau es selbst, und gib deinem Agenten den Kontext, den er braucht.

    Wo du anfangen kannst

    Wenn du das in deinem Team ausprobieren willst:

    1. Schreib auf, was du weißt. Fang mit einer Markdown-Datei an: wer ihr seid, was eure Kennzahlen bedeuten, wie eure Tonalität ist. Halte jede Definition an einem einzigen Ort.
    2. Verbinde ein System. Nimm das, auf das du am häufigsten schaust (CRM, Helpdesk, Social-Media-Analytics), und verbinde es über einen MCP-Server oder eine API.
    3. Bau ein kleines Tool für eine echte Frage. Kein Dashboard. Eine Frage, etwa „Welche Kunden warten gerade auf eine Antwort?“
    4. Schreib auf, was schiefgegangen ist, mit Datum. Diese Datei wird dein wertvollstes Asset.

    Die Tools sind der sichtbare Teil. Was du wirklich aufbaust, ist der Kontext.
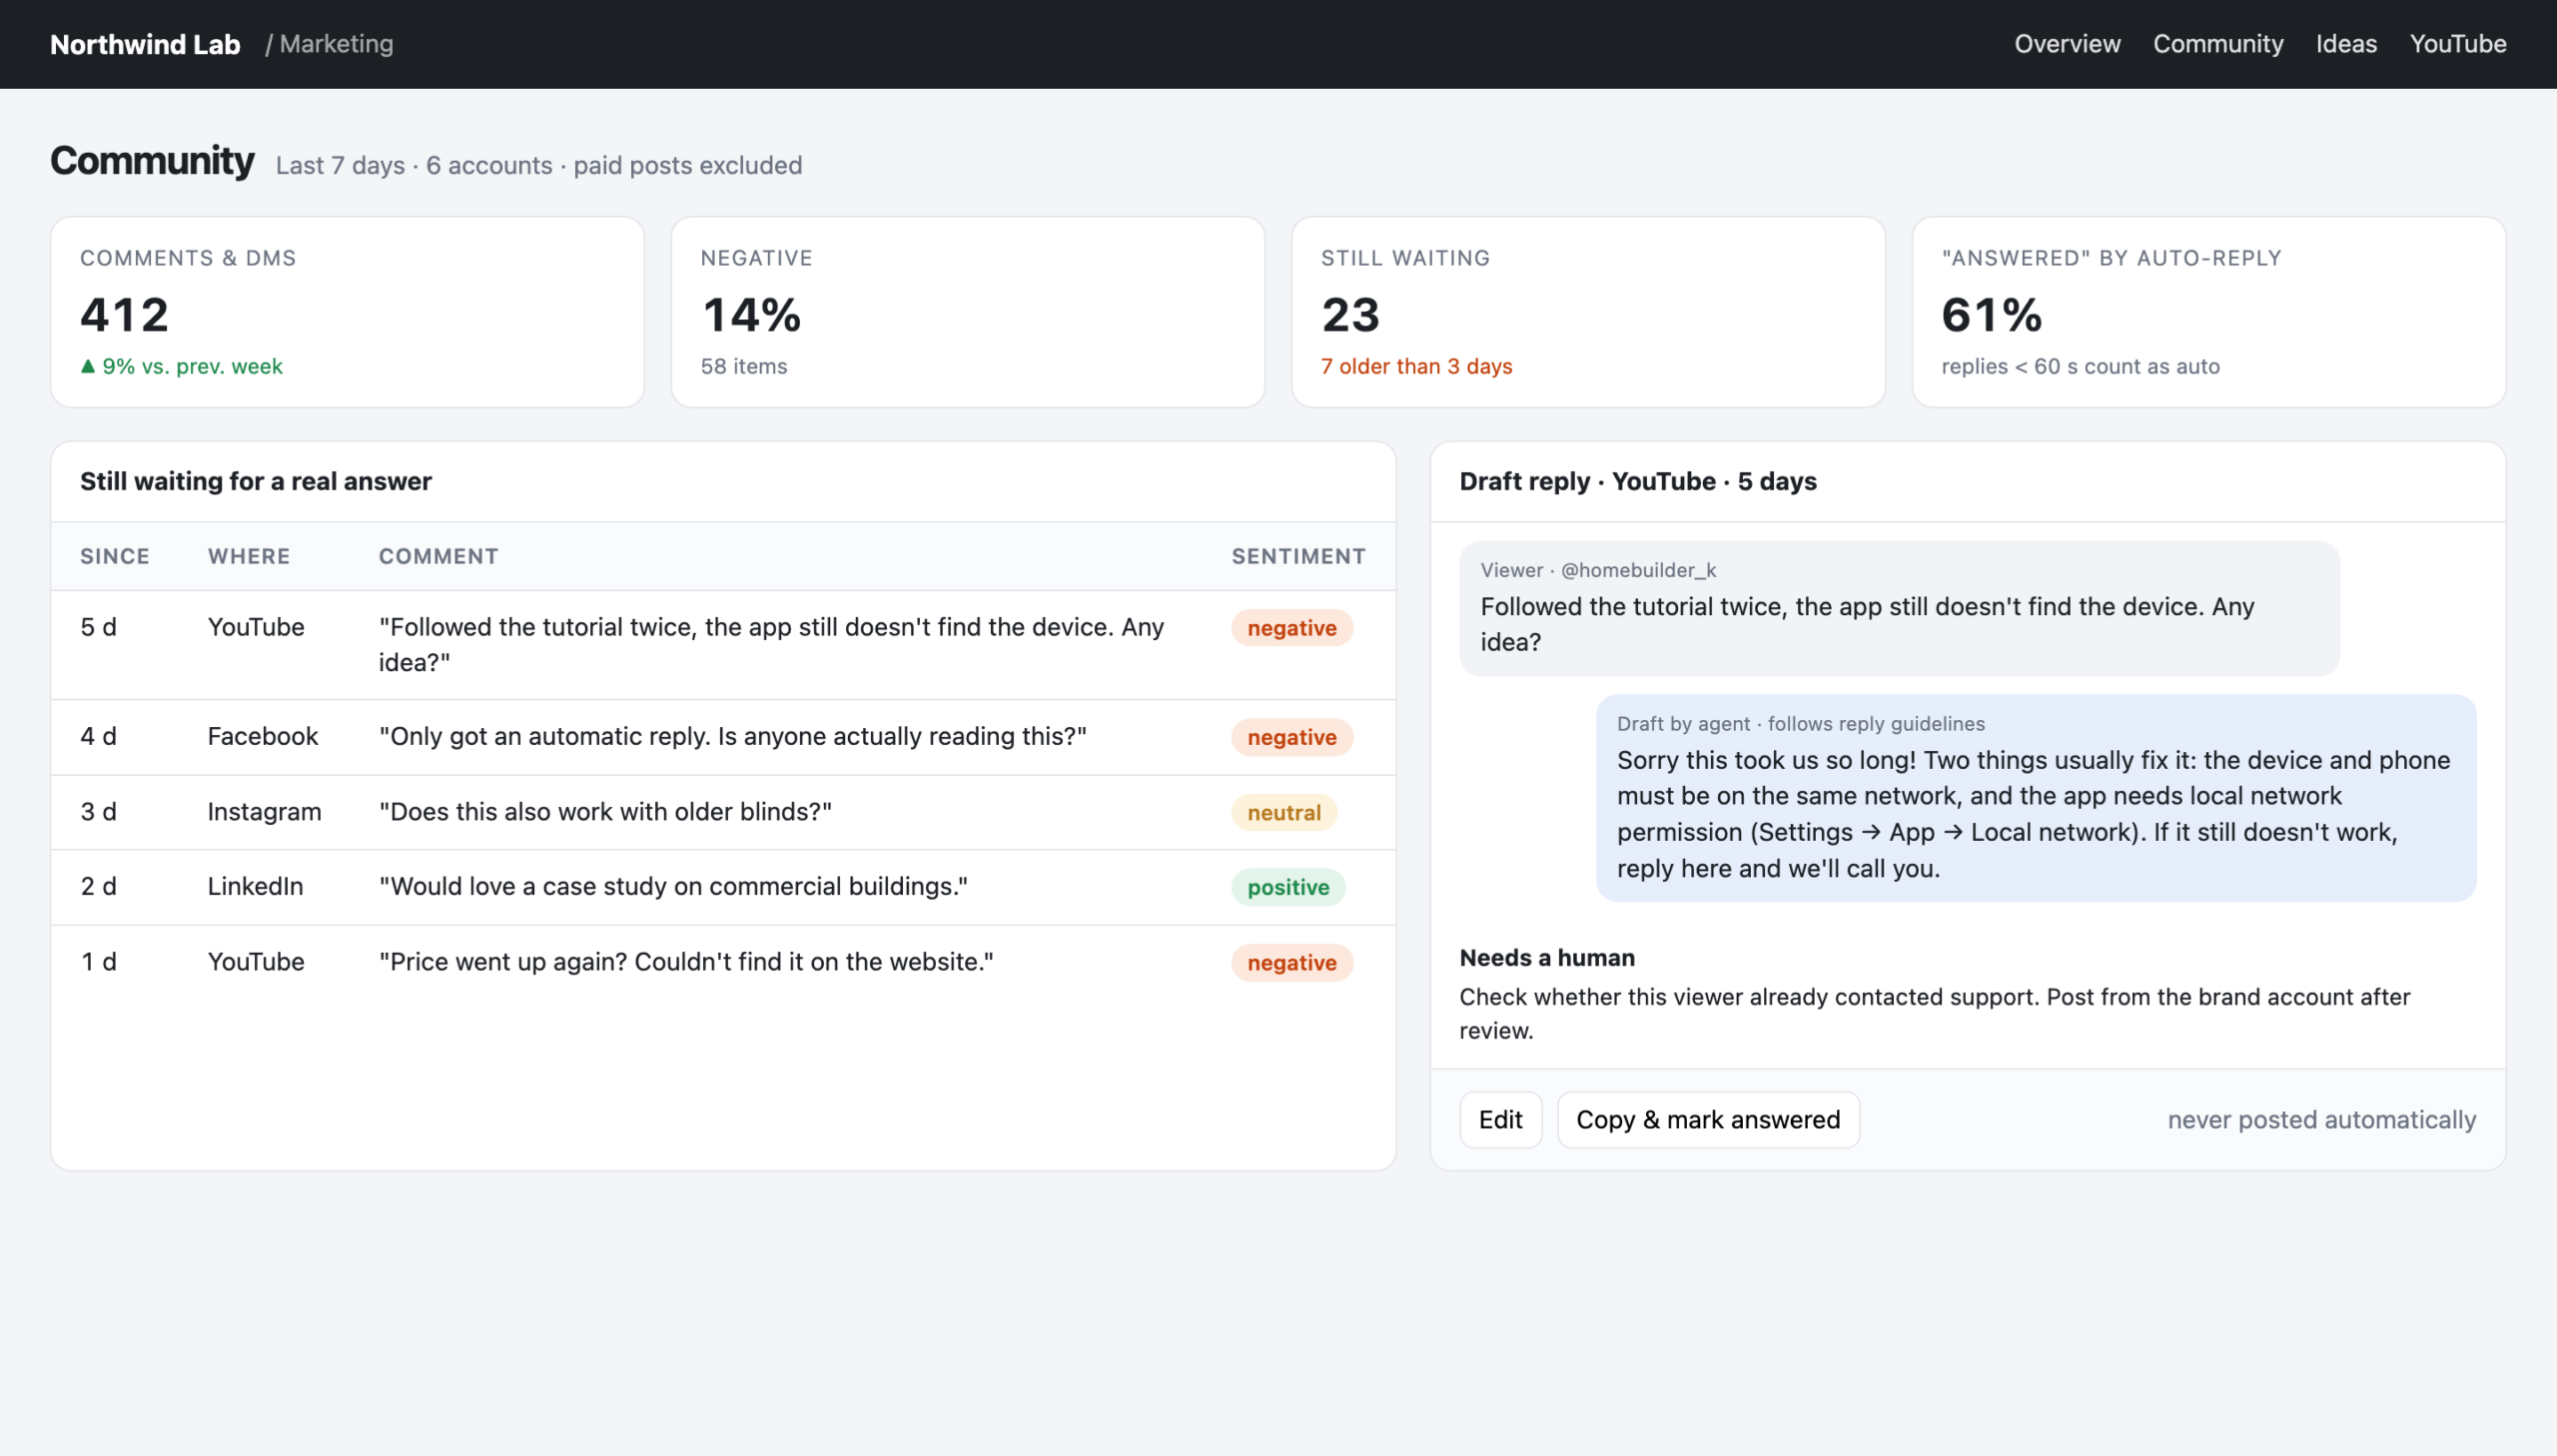
    Community-Ansicht: wer noch auf eine echte Antwort wartet, mit Antwortentwurf
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.
  • Warum Chatbots verrotten

    Warum Chatbots verrotten

    Vor ein paar Jahren hatten wir einen Support-Chatbot. Er war teuer, ein spezialisierter Anbieter hatte ihn gebaut, und am Launch-Tag hat er gut funktioniert. Ein Jahr später haben die Leute einen Bogen um ihn gemacht.

    Technisch war nichts kaputt. Der Bot hat weiterhin jede Frage beantwortet, schnell und höflich. Das Problem war, dass immer mehr Antworten falsch waren. Die Produkte hatten sich verändert, die Prozesse hatten sich verändert, die Dokumentation war weitergezogen. Der Bot nicht.

    Diese Erfahrung ist der Maßstab für jeden Chatbot, den wir seitdem gebaut haben. Und sie hat mir das Wichtigste beigebracht, was ich über Chatbots weiß: Ein Chatbot ist kein Technologieprojekt. Er ist ein Content-Pflegeproblem, das sich als Technologieprojekt verkleidet.

    Wie Bots verrotten

    Klassische Chatbots bestehen aus vorgeschriebenen Antworten. Jemand schreibt eine Liste mit Fragen und den passenden Antworten, der Anbieter trainiert ein Modell darauf, die Fragen zu erkennen, und los geht’s.

    Ab diesem Tag erzeugt jede Veränderung in deinem Unternehmen eine kleine Lücke. Eine neue Produktversion. Ein neuer Rückgabeprozess. Eine Preisänderung. Eine Funktion, die umbenannt wurde. Jede Lücke ist winzig. Niemand ist dafür zuständig, sie zu schließen, denn der Bot war ein Projekt, und das Projekt ist abgeschlossen.

    Sechs Monate später erzählt der Bot Kunden selbstbewusst Dinge, die im letzten Frühjahr gestimmt haben. Die Kunden merken es vor dir.

    Was sich mit LLMs ändert und was nicht

    Moderne Sprachmodelle verändern eine Sache grundlegend: Du musst keine Antworten mehr vorschreiben. Du kannst den Bot auf deine Dokumentation ansetzen, und er antwortet von dort. Ändert sich die Dokumentation, ändern sich auch die Antworten.

    Klingt, als wäre das Problem mit dem Verrotten gelöst. Es hat sich nur verschoben.

    Der Bot ist jetzt genau so gut wie die Dokumentation, die er liest. Ist die Doku veraltet, lückenhaft oder in Worten geschrieben, die deine Kunden nicht verwenden, ist es der Bot auch, nur eloquenter. Wie aktuell deine Wissensdatenbank ist, wird zur eigentlichen KPI deines Chatbots.

    Was wir diesmal anders machen

    Als wir dieses Jahr den alten Anbieter-Bot durch einen Assistenten auf Basis eines Sprachmodells ersetzt haben, haben wir uns ein paar Regeln gegeben.

    Mensch zuerst. Ist jemand aus dem Team online, bekommt der Kunde einen Menschen. Der Bot antwortet nur, wenn niemand verfügbar ist, etwa nachts oder am Wochenende. Er ist ein Sicherheitsnetz, kein Türsteher. Einen Support-Kanal haben wir sogar bewusst ganz ohne KI gestartet, weil die Leute, die ihn nutzen, eher einen Menschen brauchten als eine sofortige Antwort.

    Ein Bot, eine Aufgabe. Ein Bot, der Leuten hilft, das Produkt kennenzulernen, und ein Bot, der Fragen vor dem Kauf beantwortet, brauchen unterschiedliche Quellen, eine unterschiedliche Tonalität und unterschiedliche Grenzen. Wir halten sie getrennt und geben jedem einen eigenen Namen, damit Kunden und Team wissen, mit welchem sie gerade sprechen.

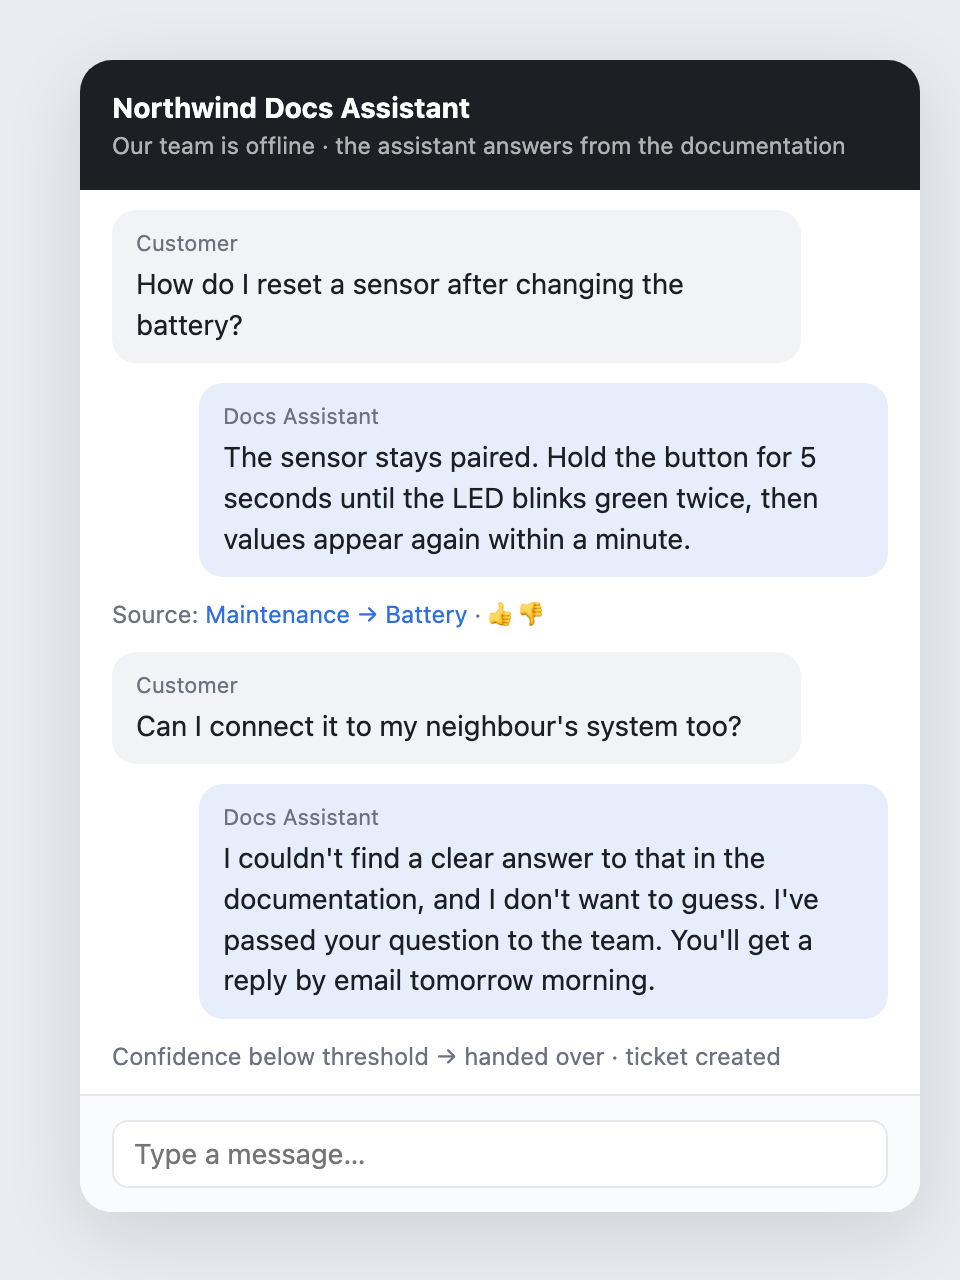
    Ablehnen statt raten. Vor dem Go-live haben wir den Dokumentations-Bot mit 200 echten Support-Fragen getestet. Die meisten Antworten waren teilweise richtig, ein paar waren falsch, und eine war eine echte Halluzination. Deshalb hat der Bot jetzt eine Konfidenzschwelle: Deckt die Dokumentation eine Frage nicht eindeutig ab, sagt er das und übergibt. Mehr dazu habe ich in Mach deine KI widersprechbar geschrieben.

    Der Doku-Bot antwortet mit Quelle und übergibt, wenn er unsicher ist
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Sprich die Sprache der Kunden. Kunden beschreiben Symptome, Dokumentation beschreibt Funktionen. Als wir jeder Suche das Vokabular der Dokumentation selbst hinzugefügt haben, hat sich die Zahl der Kundenformulierungen, die der Bot beantworten konnte, in unseren Tests ungefähr verdoppelt. Das ist keine Verbesserung am Modell. Es ist eine Verbesserung am Content.

    Jede Antwort kann bewertet werden. Daumen hoch, Daumen runter, mit Begründung. Die Bewertungen verbessern nicht nur den Bot, sie zeigen auch auf die Artikel, die Arbeit brauchen.

    Der Fehler, mit dem niemand rechnet

    Noch eine Geschichte, weil man so etwas nur lernt, wenn man einen Bot im Echtbetrieb laufen lässt.

    An einem seiner ersten Tage hat unser Bot plötzlich innerhalb von Sekunden Hunderte Anfragen an das Chat-System geschickt. Die Ursache war ein einziges Konfigurationsdetail: Die Antwort „Da kann ich nicht helfen, ich leite dich weiter“ saß an einer Stelle, an der das Chat-System sie als neue Frage behandelte. Der Bot hat auf seine eigene Weiterleitungsnachricht geantwortet, was eine weitere Weiterleitungsnachricht ausgelöst hat, und so weiter.

    Für die Kunden ist nichts Schlimmes passiert, und die Lösung war eine Zeile. Aber es ist eine gute Erinnerung: Ein Bot ist ein System, das mit anderen Systemen spricht, und diese Systeme haben ihre eigene Logik. Schau in den ersten Wochen genau hin.

    Wem gehört der Bot?

    Das ist die Frage, die entscheidet, ob ein Bot verrottet.

    Die falsche Antwort lautet: „Der Person, die ihn gebaut hat.“ Diese Person wechselt zum nächsten Projekt, und der Bot wird zum Waisenkind.

    Die richtige Antwort lautet: „Dem Team, dessen Wissen er weitergibt.“ Bei uns sind das die Leute, die die Dokumentation schreiben und pflegen, gemeinsam mit dem Support. Sie sehen die Daumen runter. Sie sehen, welche Fragen der Bot abgelehnt hat. Sie verbessern die Artikel, und der Bot wird besser, ohne dass jemand den Bot selbst anfasst.

    Eine Checkliste, bevor du einen Bot startest

    1. Wer hält das Wissen aktuell? Nenn ein Team, keine Person.
    2. Mensch zuerst oder Bot zuerst? Entscheide das bewusst, pro Kanal.
    3. Eine Aufgabe pro Bot. Getrennte Bots für getrennte Zwecke.
    4. Eine Konfidenzschwelle. Ablehnen statt raten.
    5. Bewertungen mit Begründung, weitergeleitet an die Leute, denen der Content gehört.
    6. Schau in den ersten Wochen genau hin. Bots, die mit Systemen sprechen, machen überraschende Dinge.

    Ein Chatbot verrottet nicht, weil die Technologie schlechter wird. Er verrottet, weil sich niemand dafür verantwortlich fühlt, was er weiß. Löst du das, ist die Technologie der einfache Teil.

  • Mach deine KI widersprechbar

    Mach deine KI widersprechbar

    Vor ein paar Wochen hatten unsere KI-bewerteten Chat-Reports ein Problem. Jeden Morgen markierte der Report eine Handvoll „verpasster Verkaufschancen“ in unseren Live-Chats. Und jeden Morgen schaute sich unser Vertriebsteam die Fälle an und sagte: Nein, das war keine Chance. Dieser Kunde hatte schon einen Partner. Diese Frage war rein technisch.

    Die KI war nicht dumm. Sie lag jeden Tag auf dieselbe Weise selbstbewusst falsch, weil ihr niemand etwas anderes gesagt hat.

    In dem Moment habe ich die wichtigste Designregel für KI-Reports im Marketing verstanden: Eine Analyse, der niemand widersprechen kann, wiederholt ihre Fehler jeden Tag.

    Daumen runter, mit Begründung

    Die Lösung war fast peinlich einfach. Jede KI-Bewertung in unseren Reports hat jetzt einen Daumen hoch und einen Daumen runter. Für den Daumen runter gibt es eine Bedingung: Du musst eine Begründung schreiben. Ein Satz reicht. „Kunde arbeitet schon mit einem Partner.“ „Das war eine Support-Frage, kein Sales-Lead.“

    Der Durchlauf am nächsten Tag liest diese Begründungen, bevor er irgendetwas bewertet. Die Fehler verschwinden nicht über Nacht, aber sie wiederholen sich nicht mehr. Und genauso wichtig: Das Vertriebsteam hat aufgehört, den Report zu ignorieren, weil es jetzt eine Möglichkeit hatte, ihn mitzugestalten.

    Zwei Dinge habe ich dabei gelernt:

    Chat-Report: von der KI bewertete Chats, das Transkript direkt neben der Note
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.
    • Die Begründung zählt mehr als die Stimme. Ein Daumen runter allein sagt der KI, dass sie falschlag, aber nicht warum. Ohne das Warum wird sie einfach überall vorsichtiger.
    • Feedback ist auch ein Vertrauenssignal. Einem Report, mit dem die Leute streiten können, vertrauen sie viel mehr als einem polierten, bei dem das nicht geht.

    Lass die KI keine Kategorien erfinden

    Die zweite Lektion kam von den Themen-Labels. Wir ordnen jeden Chat und jedes Ticket einem Thema zu, damit wir sehen, wonach Kunden am häufigsten fragen. Für einen Durchlauf habe ich den KI-Sub-Agenten eine Liste mit Beispielthemen mitgegeben, als kleine Hilfe.

    Sie haben sie als Inspiration verstanden. Zurück kamen fünfzehn neue, erfundene Labels, alle leicht unterschiedlich, die ich dann von Hand wieder unseren echten Kategorien zuordnen musste. Ein Trenddiagramm auf Basis von Labels, die sich von Durchlauf zu Durchlauf ändern, ist wertlos.

    Die Regel lautet jetzt: Die Labels sind eine geschlossene Liste. Passt ein Gespräch nicht dazu, antwortet der Sub-Agent mit „Sonstiges“ und ergänzt einen Vorschlag. Am Ende des Durchlaufs schaut sich die Hauptsession alle Vorschläge auf einmal an und entscheidet, ob sich ein neues Label lohnt. Von den ersten acht Vorschlägen wurden drei zu echten Labels. Die anderen fünf waren Varianten bestehender.

    Wenn du Zahlen über die Zeit vergleichen willst, gilt: Die KI darf Kategorien befüllen, aber nicht festlegen.

    Ablehnen statt raten

    Wir haben außerdem einen Dokumentations-Bot gebaut, der Produktfragen aus unserer Wissensdatenbank beantwortet. Bevor wir ihn auf Kunden losgelassen haben, haben wir ihn mit 200 echten Fragen aus Support-Tickets getestet und die Antworten von einem anderen Modell beurteilen lassen.

    Das Ergebnis war ernüchternd und nützlich. Nur ein kleiner Teil der Antworten war vollständig richtig. Die meisten waren teilweise richtig: hilfreich, um jemanden zum passenden Artikel zu schicken, aber unvollständig. Ein paar Prozent waren falsch, und eine war eine echte Halluzination: ein Befehl, den es gar nicht gibt.

    Wir haben den Bot nicht aufgegeben. Wir haben seine Aufgabe geändert. Er ist jetzt ein Wegweiser durch die Dokumentation, kein Ersatz für den Support. Und wir haben eine Konfidenzschwelle eingebaut: Deckt die gefundene Dokumentation die Frage nicht eindeutig ab, sagt der Bot, dass er es nicht weiß, und übergibt. Ein ehrliches „Weiß ich nicht“ ist mehr wert als eine flüssige falsche Antwort.

    Der Doku-Bot antwortet mit Quelle und übergibt, wenn er unsicher ist
    Nachgestellte Ansicht mit erfundenen Daten: So sieht das echte Tool aus, aber alle Namen und Zahlen hier sind ausgedacht.

    Dasselbe Prinzip gilt für unsere Analyse-Tools. Eine unserer Regeln für den Report zu Dokumentationslücken: Behaupte nie, etwas sei „nicht dokumentiert“, ohne mit mindestens zwei unterschiedlichen Formulierungen danach gesucht zu haben. Kunden und die Leute, die Dokumentation schreiben, verwenden selten dieselben Wörter.

    Abbrechen, nicht erfinden

    Viele unserer Reports laufen jeden Morgen automatisch, ohne dass jemand zuschaut. Deshalb ist eine Regel nicht verhandelbar: Fehlen Daten oder bricht eine Verbindung ab, stoppt der Durchlauf und sagt das auch. Er füllt die Lücken nicht mit plausiblen Zahlen.

    Klingt selbstverständlich. Ist es nicht. Der Instinkt eines Sprachmodells ist, hilfreich zu sein, und „hilfreich“ heißt bei fehlenden Daten: etwas erfinden. Du musst ihm ausdrücklich und schriftlich sagen, dass ein abgebrochener Report besser ist als ein erfundener.

    Den Beleg direkt neben das Urteil

    Das letzte Muster ist das einfachste. Jede Bewertung, jedes markierte Ticket, jede Content-Idee in unseren Tools verlinkt zurück auf die Quelle: das vollständige Chat-Protokoll, das tatsächliche Ticket, die echten Instagram-Kommentare, auf denen eine Idee beruht. Jeder kann durchklicken und nachprüfen.

    Das bewirkt zweierlei. Fehler werden schnell sichtbar. Und die Menschen behalten die Gewohnheit, sich die echten Gespräche anzuschauen, wo die eigentlichen Erkenntnisse ohnehin liegen.

    Eine Checkliste für deine eigenen KI-Reports

    Wenn du KI-gestützte Reports im Marketing baust, würde ich das hier vom ersten Tag an einbauen:

    1. Ein Daumen runter, der eine Begründung verlangt, und ein nächster Durchlauf, der sie liest.
    2. Geschlossene Listen für alles, was du über die Zeit zählen willst. „Sonstiges plus Vorschlag“ statt erfundener Labels.
    3. Eine Konfidenzschwelle. Ablehnen statt raten.
    4. Abbruch bei fehlenden Daten. In den Anweisungen festgeschrieben, nicht vorausgesetzt.
    5. Ein Beleg neben jedem Urteil. Ein Link zur Quelle, immer.

    Bei alldem geht es nicht um bessere Modelle. Es geht darum, die Arbeit der KI zu etwas zu machen, das Menschen prüfen, anzweifeln und verbessern können. Genau das macht aus einer beeindruckenden Demo ein Tool, auf das sich ein Team wirklich verlässt.